สารบัญ
ทุกบทความในซีรีส์นี้มาจากการที่ผมคุยกับ AI แล้วค้นข้อมูลเพิ่มเติม ผมเป็นคนกำหนดทิศทาง ให้ AI ช่วยสรุป วิเคราะห์ และเรียบเรียงออกมาเป็นบทความครับ
ในตอนที่ 3 ทีมของนกทำงานกัน 14 เดือน
ลูกค้าเพิ่งได้เห็นของจริงตอนท้าย แล้วบอกว่า “ไม่ใช่อันนี้”
ตอนนี้ขยับมาราวปี 1980
คนในวงการเริ่มเปลี่ยนวิธีคิด
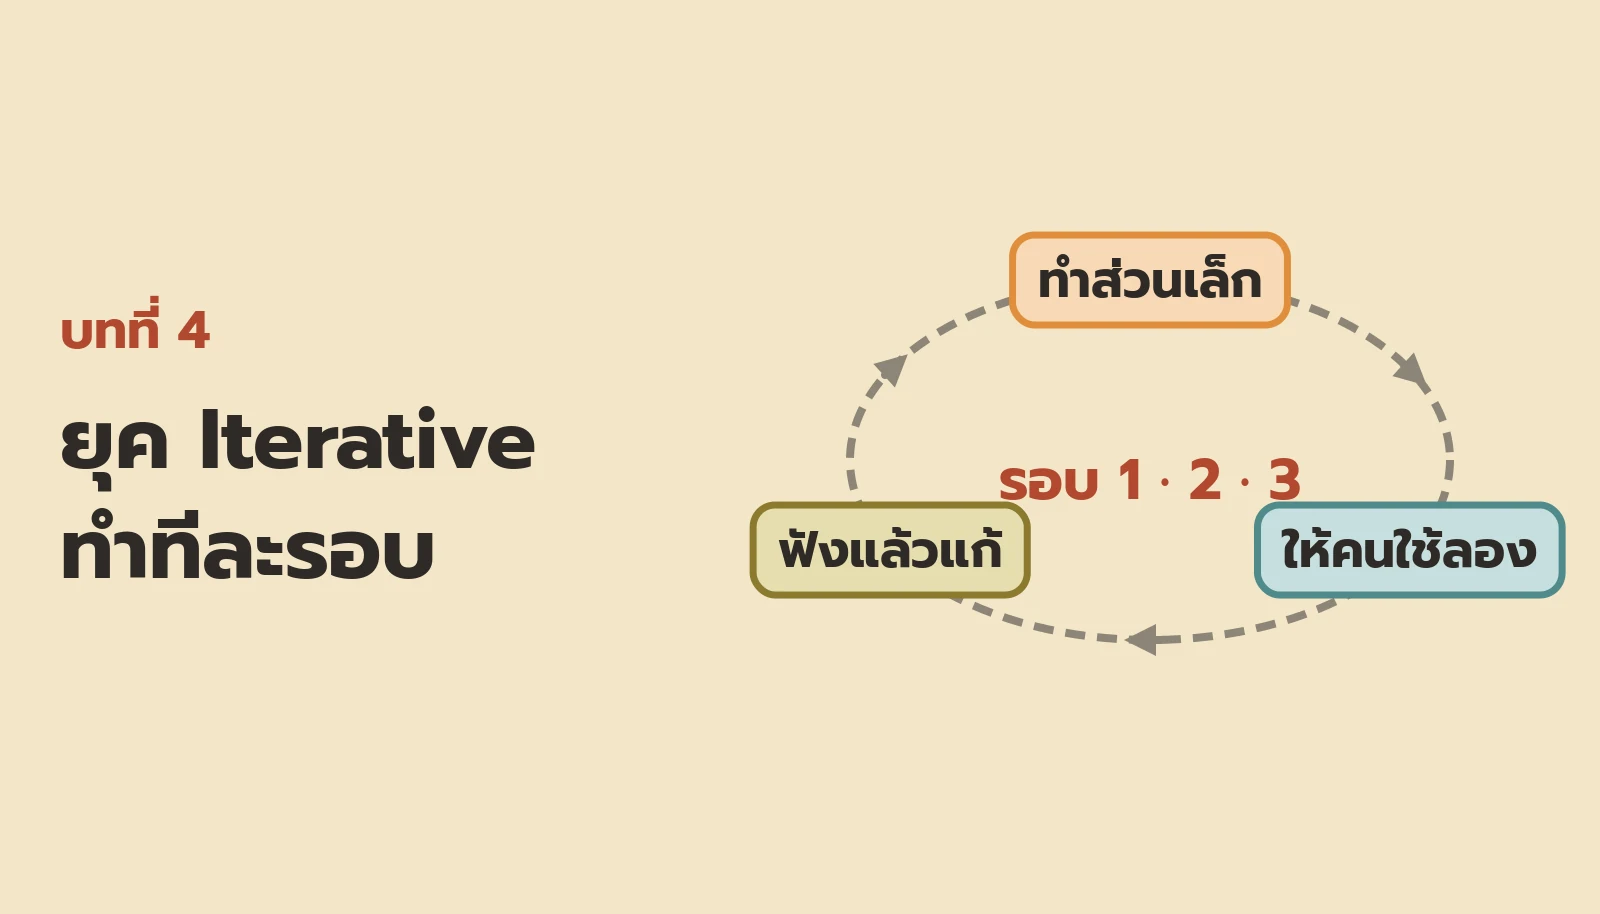
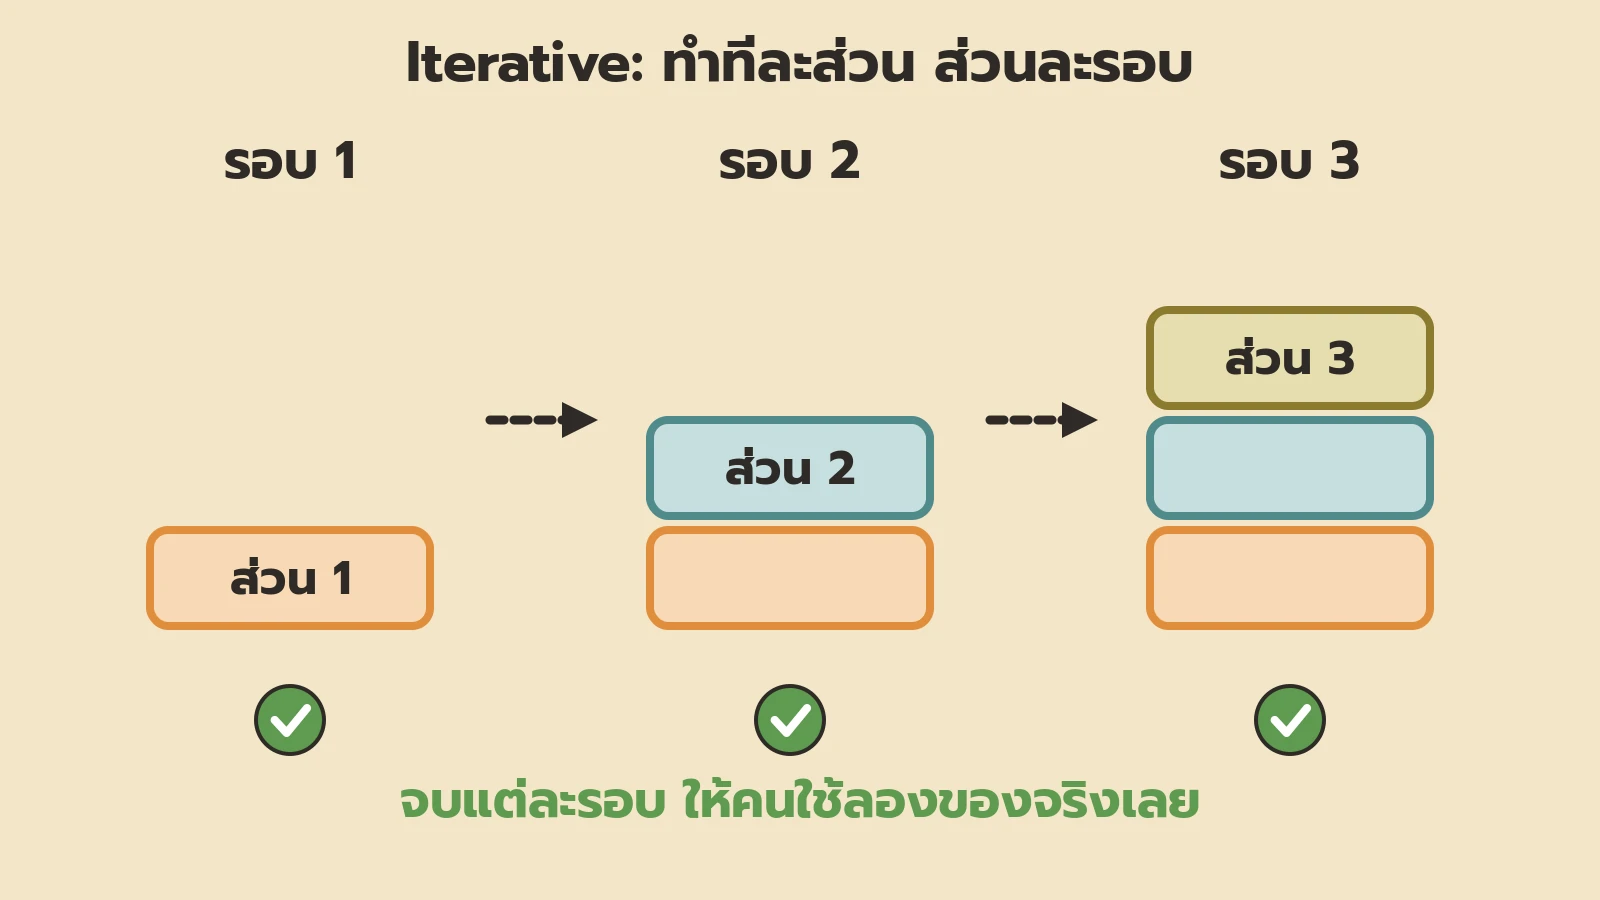
ไม่ทำทั้งระบบรวดเดียวแล้ว ทำทีละส่วน ส่วนละรอบ ทำเสร็จก็ให้คนใช้ลองเลย
วิธีนี้เรียกว่า Iterative (ทำซ้ำเป็นรอบๆ แต่ละรอบได้ของที่ใช้ได้จริงเพิ่มขึ้นทีละนิด)
รอบนี้ตัวละครหลักกลับมาเป็น “ต้น” จากตอนที่ 2
ต้นยังเป็นตัวละครสมมติเหมือนเดิมนะครับ ห้องสมุดในเรื่องก็สมมติ แต่เครื่องมือและวิธีทำงานที่ต้นเจอ เป็นของที่มีอยู่จริงในยุคนั้น
ปี 1986 ต้นได้งานห้องสมุด
สามสิบปีผ่านไปจากวันแรกที่ต้นเจาะบัตร
ตอนนี้ต้นเป็นโปรแกรมเมอร์รุ่นใหญ่ ทำงานในหน่วยคอมพิวเตอร์ของมหาวิทยาลัยแห่งหนึ่ง
งานใหม่คือทำระบบยืมคืนหนังสือให้ห้องสมุดกลาง
ห้องสมุดมีหนังสือราว 50,000 เล่ม
ทุกวันนี้ยังจดการยืมลงสมุด ส่วนการหาหนังสือ ใช้ตู้ไม้ที่มีลิ้นชักเล็กๆ เต็มผนัง ในลิ้นชักเป็นบัตรรายการ หนังสือหนึ่งเล่มมีบัตรหนึ่งใบ
หัวหน้าบรรณารักษ์ส่งรายการสิ่งที่อยากได้มาให้
ยืม คืน ค้นหนังสือ คิดค่าปรับ พิมพ์ใบทวง
ถ้าเป็นยุคตอนที่ 3 ทีมจะเขียนแฟ้ม spec ให้ครบทุกข้อ เซ็นปิดแฟ้ม แล้วหายไปทำทีเดียวปีกว่า
ต้นเคยเห็นมาแล้วว่ามันจบยังไง 555+
ทำไมยุคนี้ถึงทำทีละรอบ?
เพราะคนในวงการเจ็บกับการรอดูของจริงตอนท้ายมามากพอแล้ว
เลยเริ่มทำแบบนี้แทน
เลือกส่วนเล็กๆ ส่วนหนึ่ง ทำให้ใช้ได้จริง ให้คนใช้ลอง ฟังว่าเขาว่ายังไง แล้วค่อยทำส่วนต่อไป
วิธีนี้ไม่ได้เพิ่งคิดได้ในยุค 1980
ปี 2003 Craig Larman กับ Victor Basili เขียนบทความเล่าประวัติเรื่องนี้ ชื่อ “Iterative and Incremental Development: A Brief History” ลงในวารสาร IEEE Computer
ในนั้นเล่าว่า ทีมที่ทำ software ให้ NASA ใช้วิธีนี้มาตั้งแต่ยุค 1960 ในโครงการ Mercury (โครงการส่งคนอเมริกันขึ้นอวกาศครั้งแรก)
ต่อมาคนกลุ่มนั้นบางส่วนไปอยู่ IBM Federal Systems Division (ฝ่ายของ IBM ที่ทำงานให้รัฐบาล)
ระหว่างปี 1977 ถึง 1980 ทีมนี้ทำ software หลักที่ควบคุมการบินของกระสวยอวกาศ แบ่งงานเป็น 17 รอบ ใช้เวลารวม 31 เดือน เฉลี่ยรอบละราว 8 สัปดาห์
เหตุผลที่ไม่ทำทีละขั้นแบบ Waterfall คือความต้องการของโครงการกระสวยอวกาศเปลี่ยนไปเรื่อยๆ ระหว่างที่ทีมกำลังทำอยู่
ปี 1986 ปีเดียวกับเรื่องของต้น Barry Boehm ก็ตีพิมพ์บทความเสนอวิธีที่เขาเรียกว่า Spiral model ให้ทำเป็นรอบ และให้แต่ละรอบเริ่มจากดูว่าเรื่องไหนเสี่ยงที่สุด
ในเรื่องของเรา ต้นไม่ได้อ่านบทความพวกนี้หรอกครับ
แค่จำเดือนที่ 14 ได้ ก็พอแล้ว 555+
รอบแรก ทำเรื่องที่น่ากลัวที่สุดก่อน
ต้นถามตัวเองว่า ถ้าระบบนี้จะพัง มันจะพังเพราะอะไร
หน้าจอไม่สวย ยังแก้ทีหลังได้
เรื่องที่ต้นกลัวจริงๆ คือ ค้นหนังสือ 50,000 เล่มได้เร็วพอมั้ย
ตอนนักศึกษายืนรอที่เคาน์เตอร์ ถ้ากดค้นแล้วต้องรอนานเป็นนาที ระบบนี้ก็ไม่มีใครใช้
ถ้าปล่อยเรื่องนี้ไว้ทำทีหลัง แล้วเพิ่งมารู้ตอนท้ายว่าช้า ก็ต้องรื้อใหม่เกือบหมด
รอบแรกเลยทำแค่เรื่องเดียว
เอาข้อมูลหนังสือเข้าเครื่อง ทำหน้าค้นหาแบบเรียบๆ ไม่มีเมนูสวย ไม่มีระบบยืม ไม่มีค่าปรับ
แล้วลองค้นดูจริงๆ ว่าเร็วแค่ไหน
ยุค 1980 โปรแกรมเมอร์ใช้เครื่องมืออะไร?
ใช้ terminal จอเขียวแทนบัตรเจาะรู แก้โค้ดบนจอด้วย vi และสั่งประกอบโปรแกรมด้วย make
ก่อนไปดูว่ารอบแรกออกมาเป็นยังไง ขอเล่าเรื่องเครื่องมือของทีมต้นก่อน
เพราะเครื่องมือยุคนี้ต่างจากตอนที่ 2 และ 3 มาก
ทีมต้นไม่ต้องเจาะบัตรแล้ว
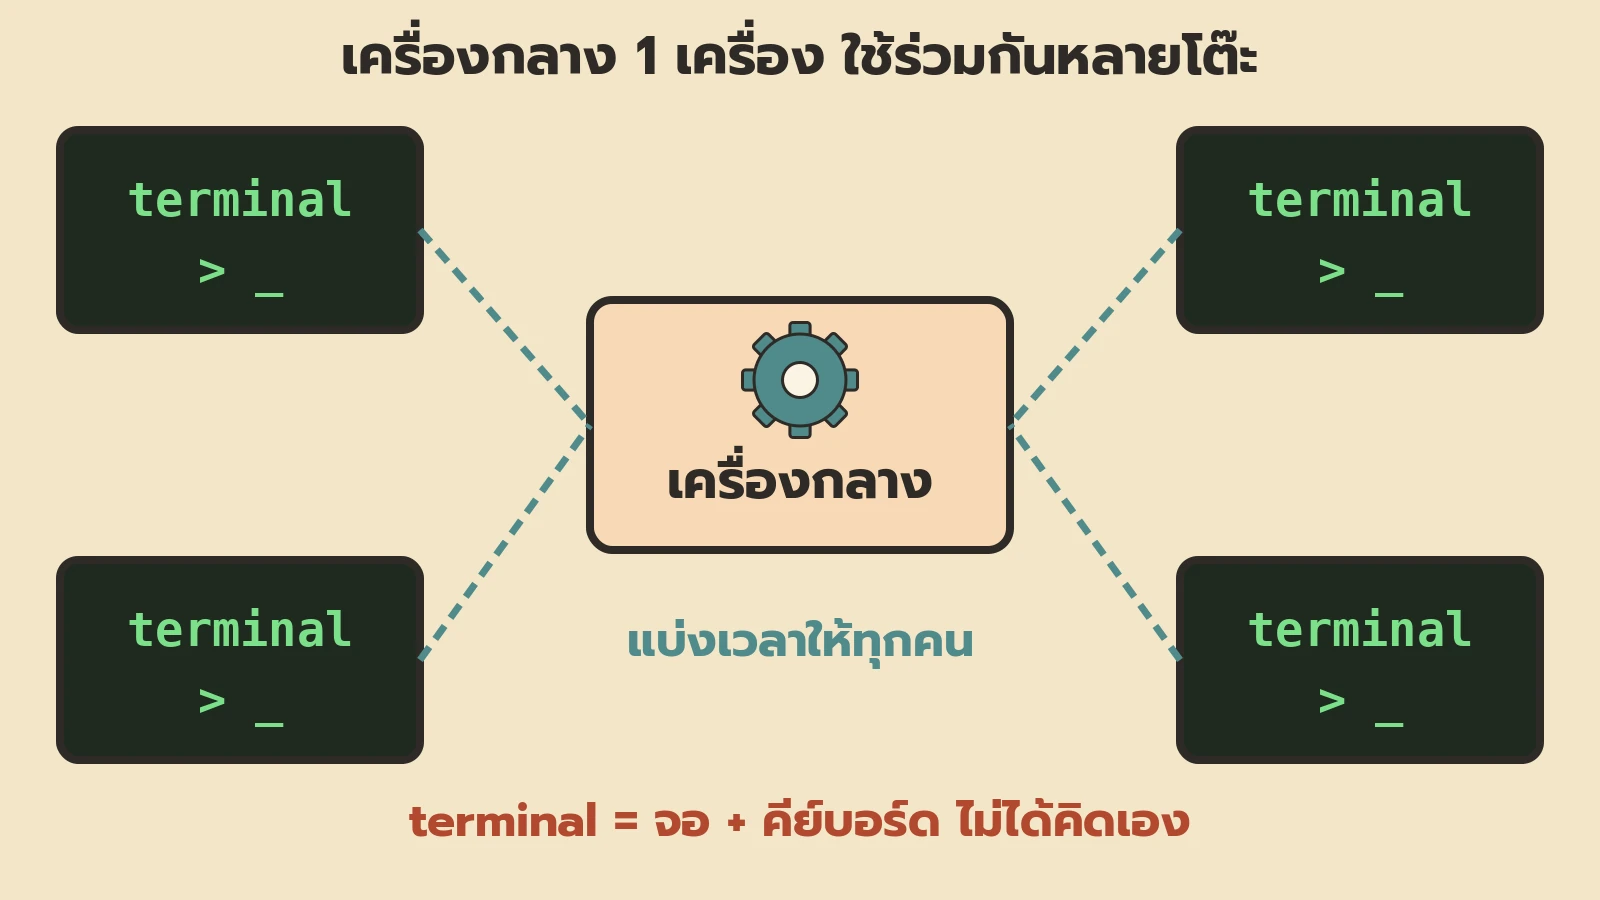
มหาวิทยาลัยมีคอมพิวเตอร์ขนาดกลางอยู่ในห้องเครื่องหนึ่งเครื่อง ใช้ร่วมกันหลายคน
แต่ละโต๊ะมี terminal (จอกับคีย์บอร์ดที่ต่อสายไปหาเครื่องกลาง ตัวมันเองไม่ได้คิดอะไร) หน้าจอสีดำ ตัวหนังสือสีเขียว
หลายคนพิมพ์งานพร้อมกันได้ เครื่องกลางแบ่งเวลาให้ทุกคนเอง
เขียนโค้ดบนจอ
ทีมต้นใช้โปรแกรมแก้ข้อความบนจอชื่อ vi ที่ Bill Joy เขียนขึ้นที่มหาวิทยาลัย Berkeley ในปี 1976
เปิดไฟล์โค้ดขึ้นมาบนจอ เลื่อนไปบรรทัดที่ต้องการ แก้ แล้วบันทึก
เทียบกับตอนที่ 2 ที่แก้ตัวเลขตัวเดียวต้องเจาะบัตรใบใหม่ หรือตอนที่ 3 ที่ต้องเขียนดินสอส่งห้องเจาะบัตร อันนี้คือแก้เองได้ทันที
รู้ผลในไม่กี่นาที
พอแก้เสร็จ สั่งเครื่องให้ทำงานได้เลย
ไม่ต้องยื่นปึกบัตรให้ operator แล้วรอถึงเช้า
ส่วนใหญ่รอไม่กี่นาทีก็เห็นผลบนจอ ถ้าผิดก็แก้ แล้วลองใหม่ วันหนึ่งลองได้หลายสิบรอบ
make สั่งประกอบโปรแกรมให้
โปรแกรมของระบบห้องสมุดแบ่งเป็นหลายไฟล์ ไฟล์ค้นหา ไฟล์ยืม ไฟล์หน้าจอ
ก่อนรันได้ ต้องแปลงโค้ดทุกไฟล์ให้เป็นโปรแกรมที่เครื่องอ่านได้ แล้วเอามาต่อกัน
ถ้าทำเองด้วยมือ ลืมไฟล์ไหนไปไฟล์หนึ่ง โปรแกรมก็ใช้ของเก่าปนของใหม่
ทีมต้นใช้ make ที่ Stuart Feldman เขียนขึ้นที่ Bell Labs ในปี 1976
เขียนไว้ครั้งเดียวว่าไฟล์ไหนต้องใช้ไฟล์ไหน แล้วพิมพ์คำว่า make คำเดียว มันจะดูเองว่าไฟล์ไหนถูกแก้ไปบ้าง แล้วทำใหม่เฉพาะส่วนนั้น
ยุคนั้นเก็บประวัติการแก้โค้ดยังไง?
ใช้เครื่องมือเก็บประวัติอย่าง SCCS และ RCS ไม่ต้องถือถาดบัตรสองถาดแล้วเดาว่าถาดไหนล่าสุด
จำถาดบัตร “คำนวณเงินเดือน” สองถาดในตอนที่ 3 ได้มั้ยครับ
สองคนแก้งานชุดเดียวกันคนละสำเนา แล้วไม่มีใครรู้ว่าถาดไหนล่าสุด
ทีมต้นมีเครื่องมือเก็บประวัติการแก้โค้ดแล้ว
ตัวแรกๆ ชื่อ SCCS ที่ Marc Rochkind เริ่มเขียนที่ Bell Labs ปลายปี 1972
ทีมต้นใช้ตัวที่ใหม่กว่า ชื่อ RCS ที่ Walter Tichy ปล่อยออกมาในปี 1982
ใช้งานแบบนี้
ใครจะแก้ไฟล์ไหน ต้อง “ยืม” ไฟล์นั้นออกมาก่อน ระหว่างนั้นคนอื่นแก้ไฟล์เดียวกันไม่ได้
แก้เสร็จก็คืนเข้าไป พร้อมเขียนโน้ตสั้นๆ ว่าแก้อะไร
เครื่องจำไว้ทุกครั้ง ว่าใครแก้ แก้เมื่อไหร่ แก้ตรงไหน และขอย้อนกลับไปเวอร์ชันเก่าได้
SCCS กับ RCS คือเครื่องมือรุ่นก่อนหน้า git ที่โปรแกรมเมอร์ทุกวันนี้ใช้กัน ส่วน git เองกว่าจะเกิดก็ปี 2005 โน่น
บรรณารักษ์ลองใช้ครั้งแรก
ผ่านไปราวสองเดือน รอบแรกเสร็จ
ค้นหนังสือได้เร็วพอ เรื่องที่ต้นกลัวที่สุดผ่านไปหนึ่งเรื่อง
ต้นยก terminal ไปวางที่เคาน์เตอร์ยืมคืน ให้คุณพี่บรรณารักษ์ลองใช้จริงกับนักศึกษา
เธอลองอยู่ครึ่งวัน แล้วเรียกต้นมาคุย
“พิมพ์ชื่อหนังสือมันช้าค่ะ ชื่อยาวบ้าง สะกดผิดบ้าง ชื่อซ้ำกันก็มี”
แล้วเธอก็ชี้ไปที่ป้ายเลขบนสันหนังสือ
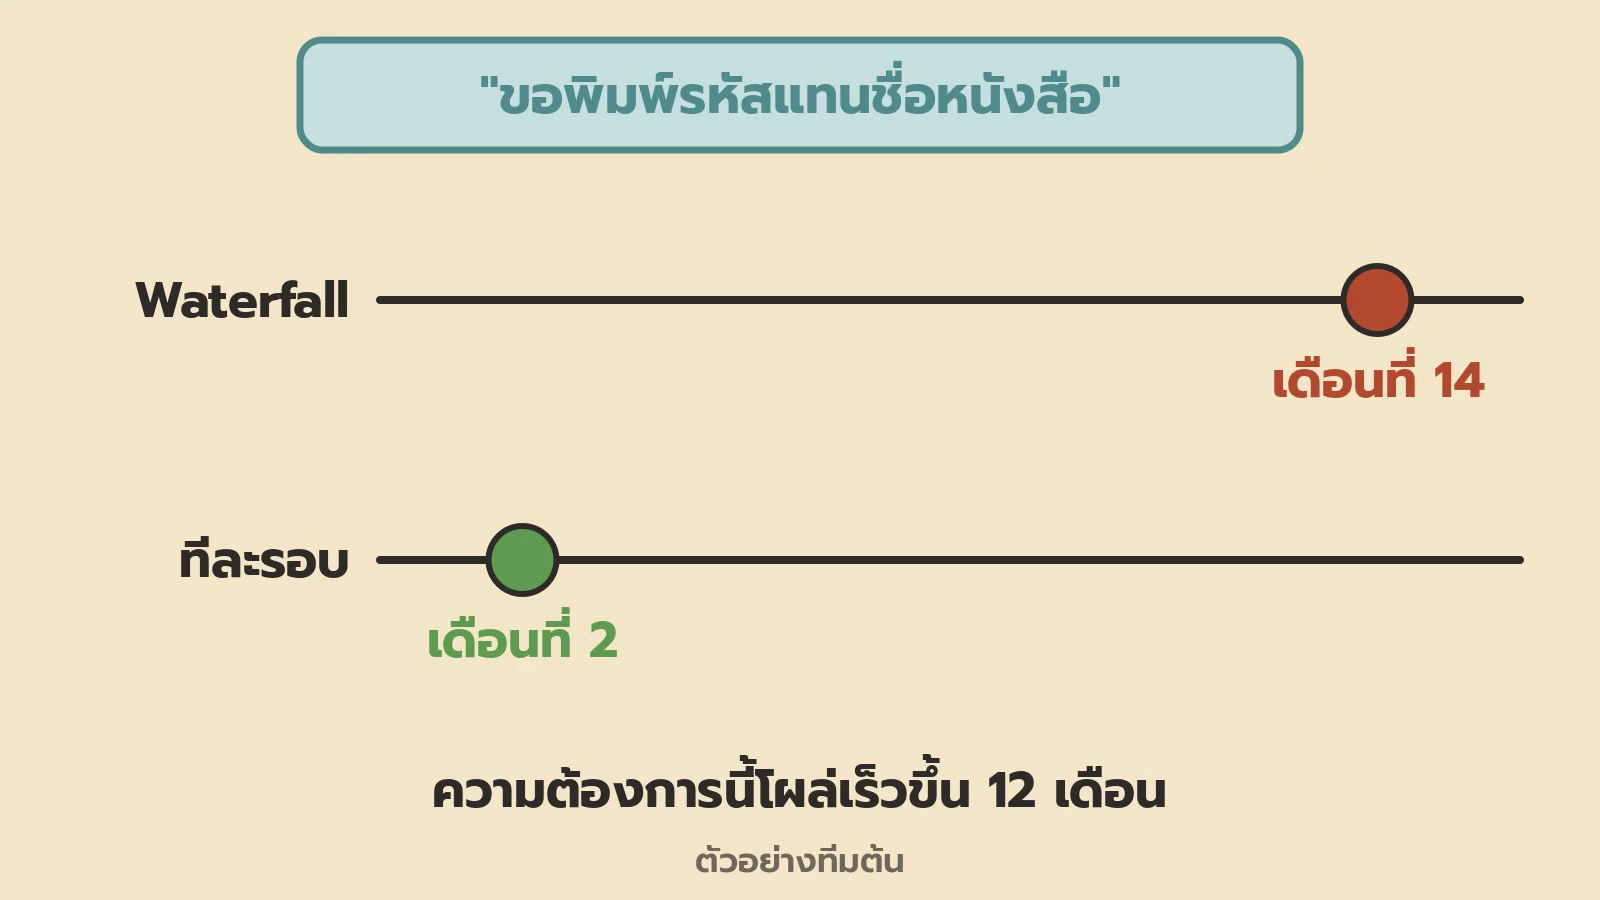
“หนังสือทุกเล่มมีรหัสติดอยู่แล้ว ขอพิมพ์รหัสแทนได้มั้ยคะ”
ต้นได้ยินแล้วนิ่งไปแป๊บหนึ่ง
ถ้าเป็นยุคตอนที่ 3 ความต้องการข้อนี้จะโผล่มาตอนเดือนที่ 14
รอบนี้โผล่มาตอนเดือนที่ 2
แก้เสร็จในสองวัน
กลับมาที่โต๊ะ ต้นเริ่มแก้
วันแรก ยืมไฟล์หน้าค้นหาออกมาจาก RCS เปิดด้วย vi เพิ่มช่องให้พิมพ์รหัสหนังสือได้
สั่ง make ให้ประกอบโปรแกรมใหม่ ลอง รู้ผลในไม่กี่นาที ผิดก็แก้ แล้วลองใหม่ วนแบบนี้ไปทั้งวัน
ระหว่างนั้น เพื่อนร่วมทีมอีกคนกำลังแก้ไฟล์หน้าจออยู่ ทั้งสองคนไม่ทับงานกัน เพราะต่างคนต่างยืมไฟล์ของตัวเอง
วันที่สอง คืนไฟล์เข้า RCS พร้อมโน้ตว่า “ค้นด้วยรหัสหนังสือได้”
บ่ายวันนั้น บรรณารักษ์ได้ลองของใหม่ที่เคาน์เตอร์แล้ว
ถ้ายังต้องเจาะบัตรแล้วรอผลข้ามคืนแบบตอนที่ 2 งานแบบนี้คงกินเวลาเป็นสัปดาห์
ระหว่างนั้นที่โต๊ะบรรณารักษ์
มีเรื่องหนึ่งที่ต้นไม่ได้คาดไว้
ห้องสมุดเพิ่งได้ PC มาเครื่องหนึ่ง เป็น IBM PC
IBM เปิดตัวเครื่องรุ่นนี้ในเดือนสิงหาคมปี 1981 เป็นคอมพิวเตอร์ที่วางบนโต๊ะทำงานได้ ใช้คนเดียว ไม่ต้องต่อเครื่องกลาง
ในเครื่องมีโปรแกรม Lotus 1-2-3 โปรแกรมตารางคำนวณที่ออกขายในเดือนมกราคมปี 1983
โปรแกรมแบบนี้ไม่ได้เริ่มที่ Lotus ตัวที่ทำให้คนรู้จักคือ VisiCalc ที่ออกมาปี 1979 บนเครื่อง Apple II
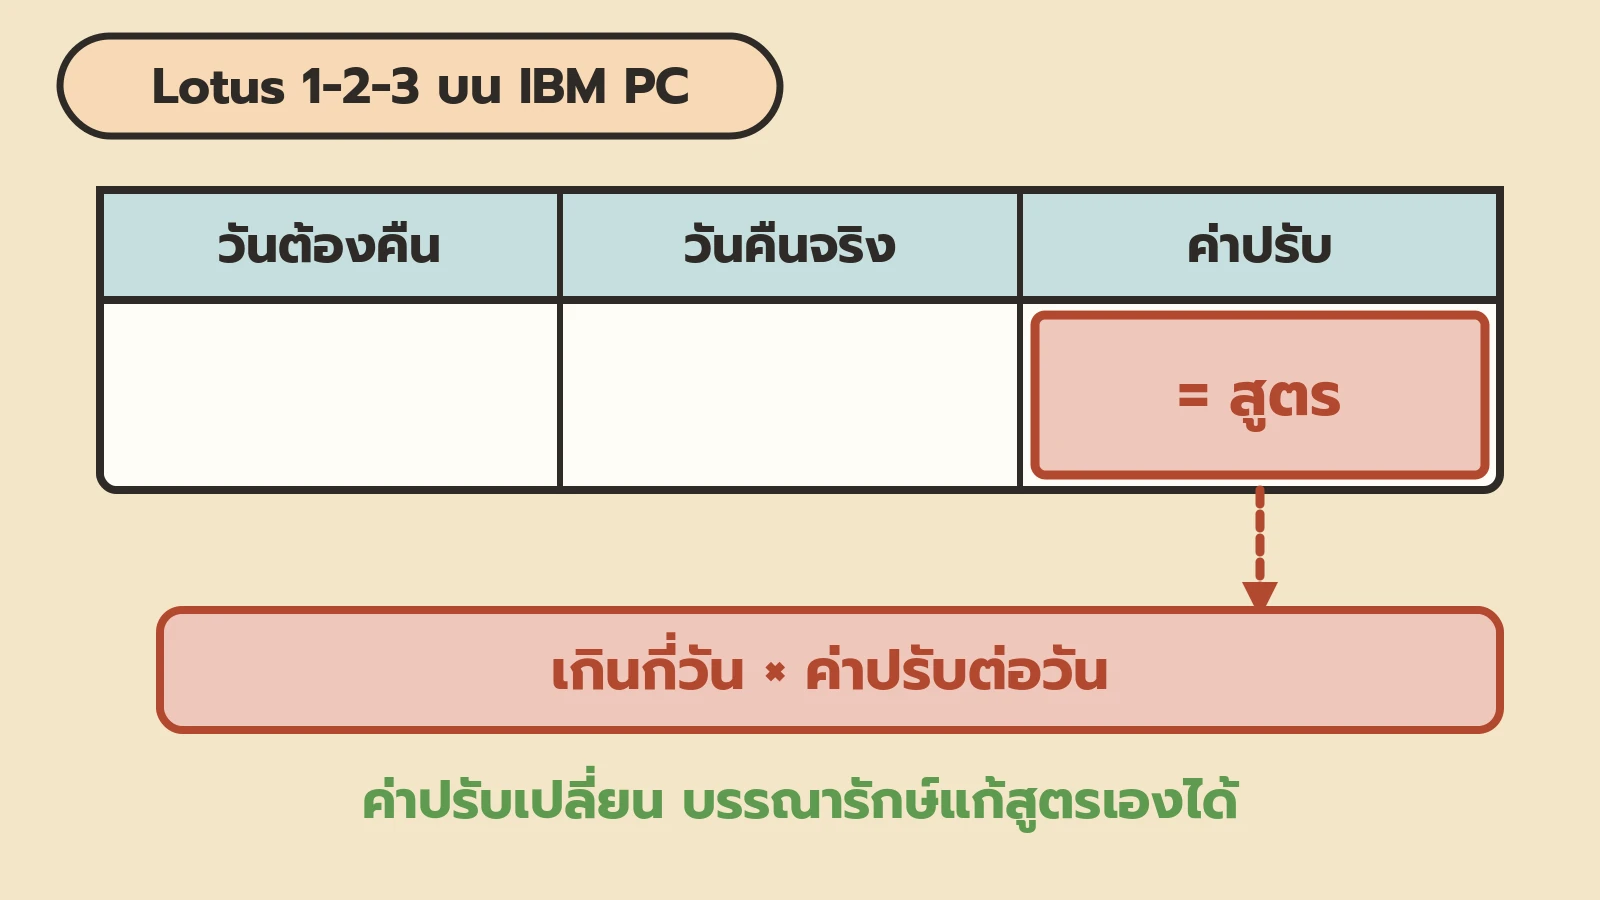
ระบบค่าปรับของต้นยังไม่เสร็จ บรรณารักษ์เลยทำตารางค่าปรับเองใน Lotus
ช่องหนึ่งใส่วันที่ต้องคืน อีกช่องใส่วันที่คืนจริง ช่องที่สามให้คำนวณว่าเกินกี่วัน แล้วคูณค่าปรับต่อวัน
พอห้องสมุดเปลี่ยนค่าปรับ เธอก็แก้สูตรในช่องนั้นเอง ไม่ต้องรอใคร
ต้นเห็นแล้วคิดในใจว่า นี่คือคนที่ไม่ได้เป็นโปรแกรมเมอร์ กำลังทำโปรแกรมเล็กๆ ไว้ใช้เองอยู่
ซึ่งก็คือเรื่องเดียวกับชื่อซีรีส์นี้เลยครับ 555+
รอบสองกับรอบสาม
รอบที่สอง ทีมทำระบบยืมกับคืน
รอบที่สาม ทำค่าปรับกับใบทวง โดยเอาสูตรในตาราง Lotus ของบรรณารักษ์มาเป็นตัวตั้ง เพราะเป็นสูตรที่ห้องสมุดใช้จริงแล้ว
ทุกรอบจบด้วยการให้บรรณารักษ์ลองที่เคาน์เตอร์
ปัญหาเจอเร็วขึ้นมาก ไม่มีใครต้องรอถึงเดือนที่ 14 แล้ว
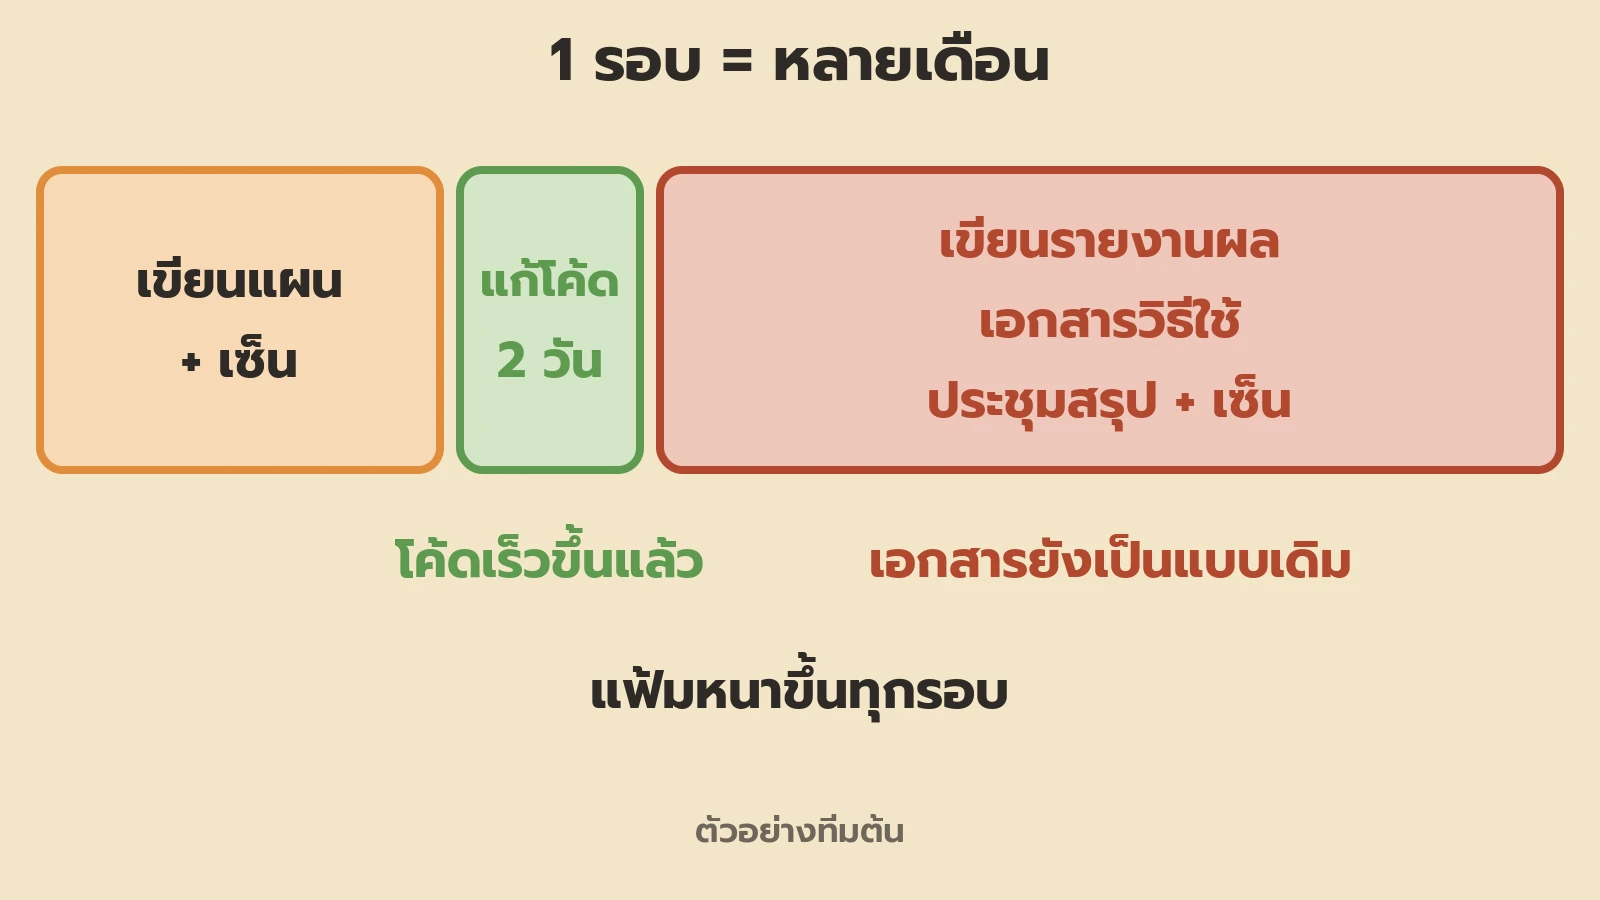
แต่แต่ละรอบก็ยังใช้เวลาหลายเดือนอยู่ดี
ก่อนเริ่มรอบใหม่ ต้องเขียนแผนของรอบนั้น ส่งให้หัวหน้าห้องสมุดเซ็น
จบรอบ ต้องเขียนรายงานผล เขียนเอกสารวิธีใช้ ประชุมสรุป แล้วเซ็นอีก
แฟ้มบนชั้นของต้นหนาขึ้นทุกรอบ
เครื่องมือเขียนโค้ดเร็วขึ้นแล้ว แต่ขั้นตอนเอกสารรอบๆ ตัวโค้ด ยังเป็นแบบเดิม
สิ่งที่ผมได้จากยุคนี้
ลองทำเอง
ตามต้นมาทั้งเรื่อง ผมว่ามีสองเรื่องที่ช่วยได้มากที่สุด
หนึ่ง ให้คนใช้ได้ลองของจริงตั้งแต่เนิ่นๆ ความต้องการเรื่องรหัสหนังสือเลยโผล่มาตอนเดือนที่ 2 ไม่ใช่เดือนที่ 14
สอง ทำเรื่องที่เสี่ยงที่สุดก่อน ถ้าค้นหาช้า รู้ตั้งแต่รอบแรก ยังแก้ทัน
และเครื่องมืออย่างจอเขียว vi make RCS ก็ทำให้การแก้ตามที่คนใช้ขอ เสร็จได้ในสองวัน
เก็บศัพท์
| ศัพท์ | ความหมายแบบภาษาคน |
|---|---|
| Iterative | ทำเป็นรอบๆ แต่ละรอบได้ของที่ใช้ได้จริงเพิ่มขึ้น |
| terminal | จอกับคีย์บอร์ดที่ต่อสายไปใช้คอมพิวเตอร์เครื่องกลาง |
| vi | โปรแกรมแก้ข้อความบนจอ ปี 1976 |
| make | โปรแกรมที่ดูว่าไฟล์ไหนถูกแก้ แล้วประกอบโปรแกรมใหม่ให้เฉพาะส่วนนั้น |
| SCCS / RCS | เครื่องมือเก็บประวัติการแก้โค้ด รุ่นก่อน git |
| Spiral model | วิธีของ Barry Boehm ที่ทำเป็นรอบ และเริ่มแต่ละรอบจากเรื่องที่เสี่ยงที่สุด |
| PC | คอมพิวเตอร์ตั้งโต๊ะที่คนเดียวใช้ |
| Lotus 1-2-3 | โปรแกรมตารางคำนวณยอดนิยมบน IBM PC |
จดบันทึก
ถ้าเพิ่งเข้ามาอ่านตอนนี้ ย้อนไปเริ่มที่ตอนที่ 1 ได้ครับ
ตอนที่ 2 สอนว่ายิ่งรู้ว่าผิดช้า ยิ่งเจ็บ
ตอนที่ 3 สอนว่ารอยต่อระหว่างคนคือที่ที่ความผิดซ่อนอยู่
ตอนนี้ได้คำตอบส่วนหนึ่ง ให้คนใช้ดูเร็ว และจัดการเรื่องที่น่ากลัวที่สุดก่อน
แต่ก็ยังเหลือคำถามค้างอยู่ข้อหนึ่ง
ถ้าโค้ดแก้เสร็จในสองวันได้แล้ว ทำไมแต่ละรอบยังต้องใช้เวลาเป็นเดือนๆ อยู่อีก?
คำถามที่พบบ่อย
Iterative development คืออะไร?
วิธีสร้าง software ที่แบ่งงานเป็นรอบ แต่ละรอบทำให้ได้ส่วนที่ใช้ได้จริงหนึ่งส่วน ให้คนใช้ลอง แล้วเอาความเห็นไปใช้ในรอบถัดไป
Iterative ต่างจาก Waterfall ยังไง?
Waterfall ทำทีละขั้นให้ครบทั้งระบบ เขียน spec ให้เสร็จก่อน แล้วค่อยเขียนโค้ดและทดสอบตอนท้าย ส่วน Iterative ทำเป็นรอบเล็กๆ แต่ละรอบได้ของที่ใช้ได้จริงให้คนใช้ลอง เลยเจอปัญหาเร็วกว่า
Iterative เพิ่งเกิดในยุค 1980 หรือเปล่า?
ไม่ใช่ครับ บทความของ Larman กับ Basili ปี 2003 เล่าว่ามีคนใช้มาตั้งแต่ยุค 1960 เช่นทีม software ของโครงการ Mercury ของ NASA และ software ควบคุมการบินของกระสวยอวกาศที่ IBM ทำช่วงปี 1977 ถึง 1980 แบ่งเป็น 17 รอบ
Spiral model คืออะไร?
วิธีที่ Barry Boehm เสนอในบทความปี 1986 และตีพิมพ์อีกฉบับในวารสาร IEEE Computer ปี 1988 ให้ทำงานเป็นรอบ และเริ่มแต่ละรอบจากการดูว่าเรื่องไหนเสี่ยงที่สุด
git มีตั้งแต่ยุคนั้นเลยมั้ย?
ยังครับ ยุคนั้นใช้ SCCS ที่เริ่มเขียนปี 1972 กับ RCS ที่ปล่อยปี 1982 ส่วน git เพิ่งเกิดปี 2005
Next → ตอนที่ 5: ยุค Agile รอบละ 2 สัปดาห์ ตอนหน้าเป็นยุค Agile ถ้าแต่ละรอบไม่ต้องยาวเป็นเดือน แต่เหลือแค่ไม่กี่สัปดาห์ แล้วเอกสารกองนั้นจะเหลือแค่ไหน ผมจะลองดูครับ