สารบัญ
ตอนที่แล้ว codebase ที่ไม่เน่า ทุก repo เกิดมาพร้อมกฎชุดเดียวกัน
ตอนนี้เราจะได้ runbook หน้าเดียว กับ backup ที่ลองกู้แล้วจริง
ตอนหน้าเมื่อบริษัทโตและ agent ใช้เงินแทนเรา เราจะได้เพดานค่าใช้จ่ายและปุ่มหยุด
ทุกบทความในซีรีส์นี้มาจากการที่ผมคุยกับ AI แล้วค้นข้อมูลเพิ่มเติม ผมเป็นคนกำหนดทิศทาง ให้ AI ช่วยสรุป วิเคราะห์ และเรียบเรียงออกมาเป็นบทความครับ
เราอยู่ตรงไหนของแผนที่
บนแถบ 5 ขั้น คราวนี้ Run สว่าง
ชิ้นจิ๊กซอว์ที่ 8 พังตอนตีสาม คือเรื่องที่ 17 มองเห็นระบบ เรื่องที่ 18 ระบบล่มและรับมือเหตุ และเรื่องที่ 19 backup และกู้คืน
ชิ้นนี้ปิดช่วงที่ 2 เมื่อมีลูกค้าจริง
หัวใจของตอนนี้
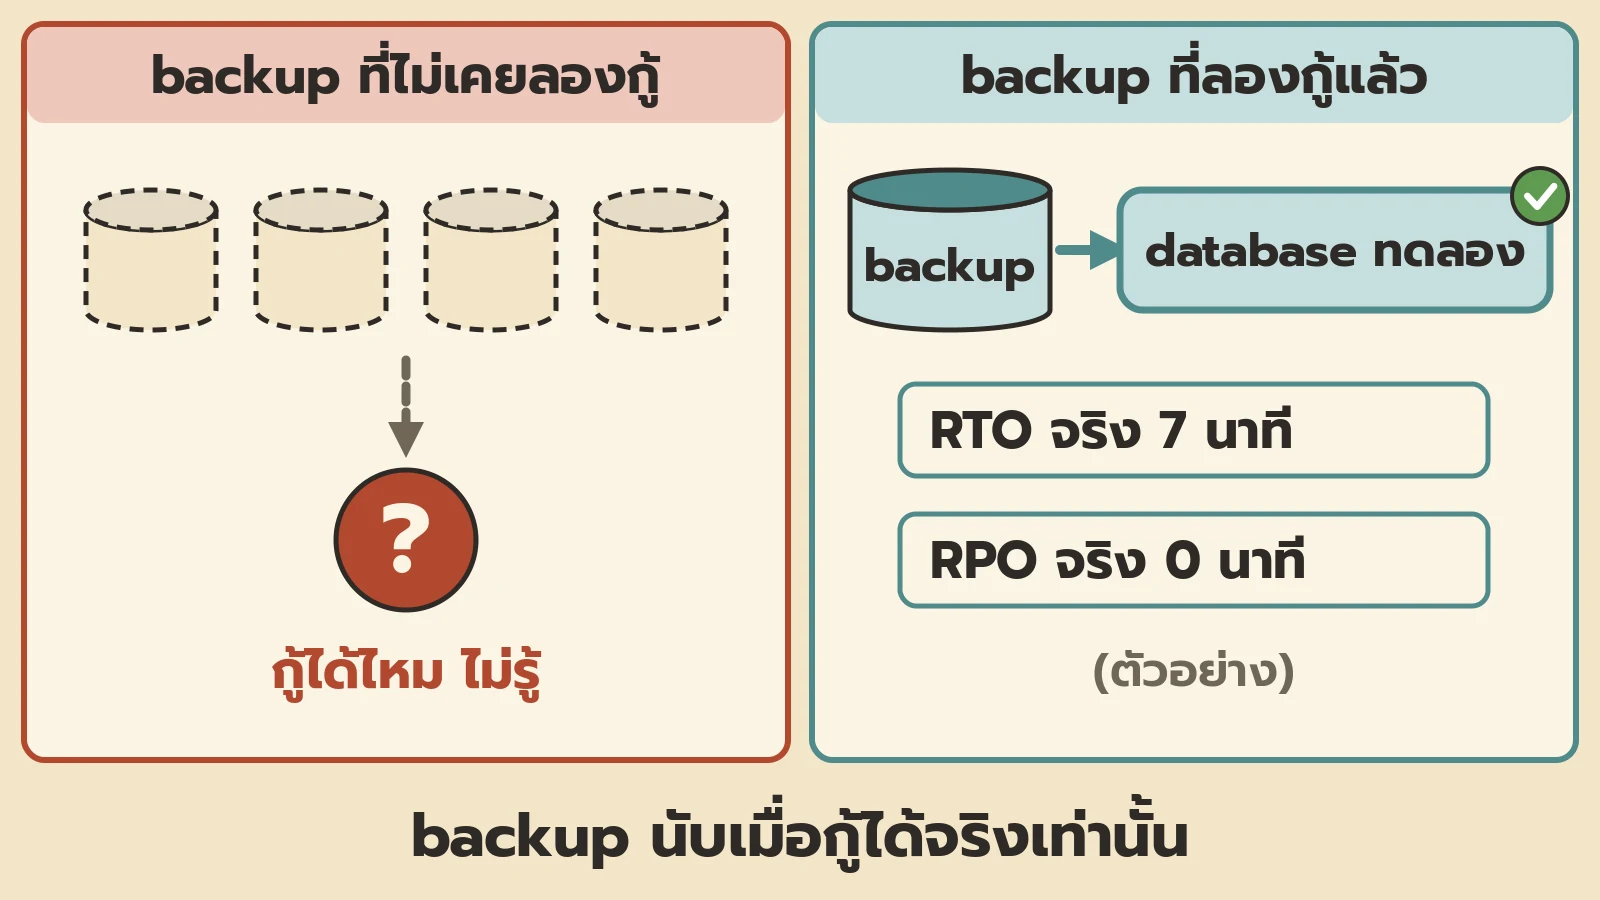
backup ที่ไม่เคยลองกู้ ไม่ใช่ backup และระบบต้องบอกเราก่อนลูกค้า
ทำไมเรื่องนี้สำคัญ?
ตอน 7 กับ 8 ทำให้ทุก repo มีด่านและทางถอยแล้ว
แต่ทางถอยช่วยได้เฉพาะเรื่องที่เรารู้ทัน
ถ้าไม่มีสัญญาณเตือน เราจะรู้จากลูกค้า
ถ้า backup กู้ไม่ได้จริง ข้อมูลที่หายก็หายถาวร
ทางถอยของตอน 7 ถอย build ได้ แต่ถอยข้อมูลไม่ได้
หลัก 5 ข้อข้างล่างคือวิธีทำให้หัวใจข้อนี้เป็นจริง
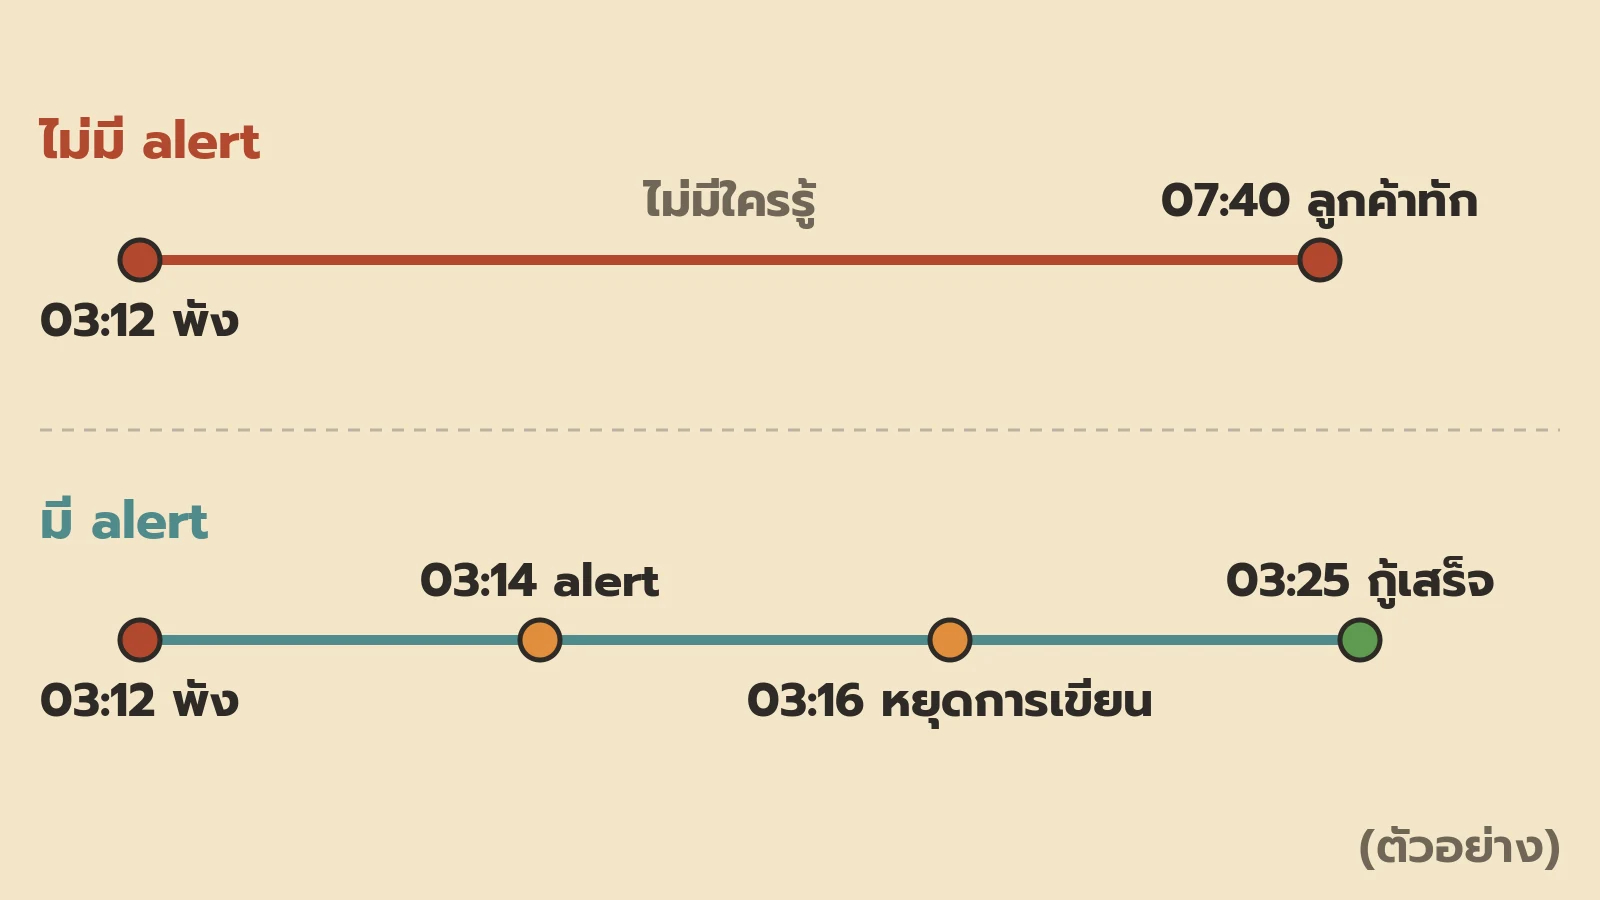
03:12 ที่มิวทักมาก่อน
ตีสามสิบสองนาที หน้าจองคิวของมิวตอบ 500 (ตัวอย่าง)
ต้นหลับอยู่ ไม่มี alert สักตัว
07:40 มิวส่ง LINE มาว่า “ระบบเข้าไม่ได้ตั้งแต่ตีสาม” (ตัวอย่าง)
ต้นเปิด log แล้วเจอว่า migration ตัวหนึ่งทำตารางเสียไปหนึ่งตาราง
เขาจะกู้จาก backup รายคืน
แล้วก็พบว่าไฟล์ dump มีขนาด 0 byte มา 3 สัปดาห์แล้ว (ตัวอย่าง)
เรื่องจริง: GitLab.com คืนวันที่ 31 มกราคม 2017
เรื่องของต้นแต่งขึ้น แต่เรื่องนี้เกิดขึ้นจริง
GitLab เขียน postmortem ทางการ ไว้เอง
ระบบของเขามี backup ที่ทำทุกวัน: “Every 24 hours a backup is generated using pg_dump”
คืนนั้นเขาต้องใช้มัน แล้วเขียนว่า “When we went to look for the pg_dump backups we found out they were not there. The S3 bucket was empty”
สาเหตุคือ backup ใช้ pg_dump 9.2 ขณะที่ database เป็น PostgreSQL 9.6
เขาสรุปไว้ว่า “Azure disk snapshots were not enabled for the database servers, and the periodic database backups using pg_dump were not working.”
ที่กู้ได้เพราะวิศวกรคนหนึ่งทำ LVM snapshot ไว้ใช้กับ staging ก่อนเริ่มงานตอนประมาณ 17:20 UTC ซึ่งเป็นตัวเลือกเดียวที่ข้อมูลหายน้อยที่สุด
ข้อมูลที่เกิดระหว่าง 17:20 ถึง 00:00 UTC หายไป เขาประเมินว่ากระทบราว 5,000 project, 5,000 comment และ 700 บัญชีผู้ใช้ใหม่ ส่วน code repository และ wiki ไม่หาย
ประโยคที่เขาเขียนไว้เองคือ “Losing production data is unacceptable”
backup ที่มีอยู่ในคืนนั้นไม่ได้ช่วย เพราะมันเสียมานานโดยไม่มีใครรู้ ถ้าเคยลองกู้สักครั้งก็จะเจอก่อนวันจริง
ทุก repo มีกฎแล้ว แต่ไม่มีใครเฝ้า
ทางถอยของตอน 7 สมมติว่ามีคนเห็นปัญหาก่อน
template ของตอน 8 ส่งกฎชุดเดียวกันให้ทุก repo
ตอนนี้ template ต้องส่ง alert ชุดเดียวกัน health check และลิงก์ไป runbook ไปด้วย
lauren (@poteto) เขียนไว้ ว่า “we rely on experiments, root causing, observability to deal with systems we don’t understand.”
ไม่มีใครเข้าใจระบบได้ทั้งหมด เราจึงต้องมีเครื่องมือที่บอกว่าตอนนี้เกิดอะไรขึ้น
หลัก 1: เตือนจากอาการที่ลูกค้าเห็น
ถ้าระบบจะบอกเราก่อนลูกค้า มันต้องดูสิ่งที่ลูกค้าเห็น
Google SRE book เขียนไว้ ว่า “Your monitoring system should address two questions: what’s broken, and why?”
DORA เขียนไว้ ว่า “Good monitoring is a staple of high-performing teams”
ต้นเริ่มจาก alert แค่ 3 ตัว:
- health check ล้ม 2 ครั้งติด (ตัวอย่าง)
- error rate เกิน 2% นาน 5 นาที (ตัวอย่าง)
- backup job รันไม่จบ
เครื่องมือเป็นแค่ตัวอย่าง เช่น Sentry แผน Developer ราคา $0 และ “Limited to one user” ตามหน้าราคา
Chris Sev หัวหน้าทีม DevRel ที่ Auth0 เล่าไว้ ว่าเขาให้ agent “watching for PRs that merged and testing production to see if anything broke” และ “i have notifications on @sentry and @posthog”
หลัก 2: runbook หน้าเดียวที่เปิดตอนง่วงแล้วทำตามได้
ระบบบอกเราแล้วยังไม่พอ ตอนตีสามเราต้องรู้ว่าจะทำอะไรก่อน
runbook ของต้นมี 5 ขั้น:
- ดูอาการ จากลิงก์ dashboard และ log
- ถอยก่อน แล้วค่อยหาสาเหตุ ใช้สูตรถอยของตอน 7
- ถ้าข้อมูลเสีย หยุดการเขียนข้อมูล แล้วกู้ตามหลัก 3
- แจ้งลูกค้า ด้วยข้อความที่เขียนไว้ล่วงหน้า
- เปิด ticket สำหรับ postmortem
runbook บอกด้วยว่าใครทำอะไรได้ ใช้ตัวตนจากตอน 5 และทางด่วนจากตอน 7
| งาน | agent-ops | ต้น |
|---|---|---|
| อ่าน log และ dashboard | ทำเองได้ | ทำได้ |
| redeploy build ก่อนหน้า | ทำเองได้ | ทำได้ |
| restore database | ไม่ได้ | ทำเท่านั้น |
| ใช้ทางด่วนข้ามด่าน | ไม่ได้ | ทำเท่านั้น |
หลัก 3: backup นับเมื่อกู้ได้จริงเท่านั้น
นี่คือครึ่งแรกของประโยคในกล่องหัวใจ
AWS Well-Architected ข้อ REL09-BP04 เขียนไว้ ว่า “Perform periodic recovery of the data to verify backup integrity and processes”
และอธิบายว่า “Testing the recovery of the backups verifies that data can be restored when needed without having any worry that data might be missing or corrupted, that the restoration and recovery is possible within the RTO for the workload”
RTO คือกู้เสร็จในเวลาเท่าไหร่ RPO คือข้อมูลหายย้อนไปได้มากสุดแค่ไหน
database แบบ managed หลายเจ้ามี PITR เช่น Neon เขียนไว้ ว่า “instant restore capability, also known as point-in-time restore or PITR, you can restore a root branch to an earlier state”
ย้อนได้นานแค่ไหนขึ้นกับแผนที่ใช้ ต้องเช็กเอง
ทุกเดือนต้นทำ 4 อย่าง:
- กู้ไปที่ branch ทดลอง ไม่แตะของจริง
- นับแถวในตารางสำคัญ
- เปิดแอปต่อกับ branch นั้น แล้วลอง login
- จด RTO และ RPO ที่วัดได้จริงลงบันทึก
หลัก 4: ฝึกก่อนวันจริง
runbook ที่ไม่เคยใช้ก็เหมือน backup ที่ไม่เคยกู้ เราไม่รู้ว่ามันใช้ได้
Google SRE book เขียนไว้ ว่า “SREs break our systems, watch how they fail, and make changes to improve reliability”
ต้นซ้อมทุกไตรมาส ครั้งละ 30 นาที (ตัวอย่าง)
เขาปิดแอป preview เอง เปิดจับเวลา แล้วทำตาม runbook ทีละขั้น
ขั้นไหนผิด เขาแก้ runbook ทันที
หลัก 5: postmortem ที่ไม่โทษใคร รวมถึง agent
พังแล้วต้องไม่พังแบบเดิมซ้ำ ระบบถึงจะบอกเราได้เร็วขึ้นทุกครั้ง
Google SRE book เขียนไว้ ว่า “A postmortem is a written record of an incident, its impact, the actions taken to mitigate or resolve it, the root cause(s), and the follow-up actions”
และต้อง “must focus on identifying the contributing causes of the incident without indicting any individual or team”
ถ้า agent เป็นคนทำพลาด ผลของ postmortem คือกฎใหม่ ไม่ใช่การโทษ
Chris Sev เขียนไว้ ว่า “you should always be creating new instructions using pstack’s /correct so it doesnt happen again”
lauren ตอบเขา ว่า “yeah, codebase is memory!”
GitLab เองก็เปิด postmortem ให้ทุกคนอ่าน ตามลิงก์ด้านบน
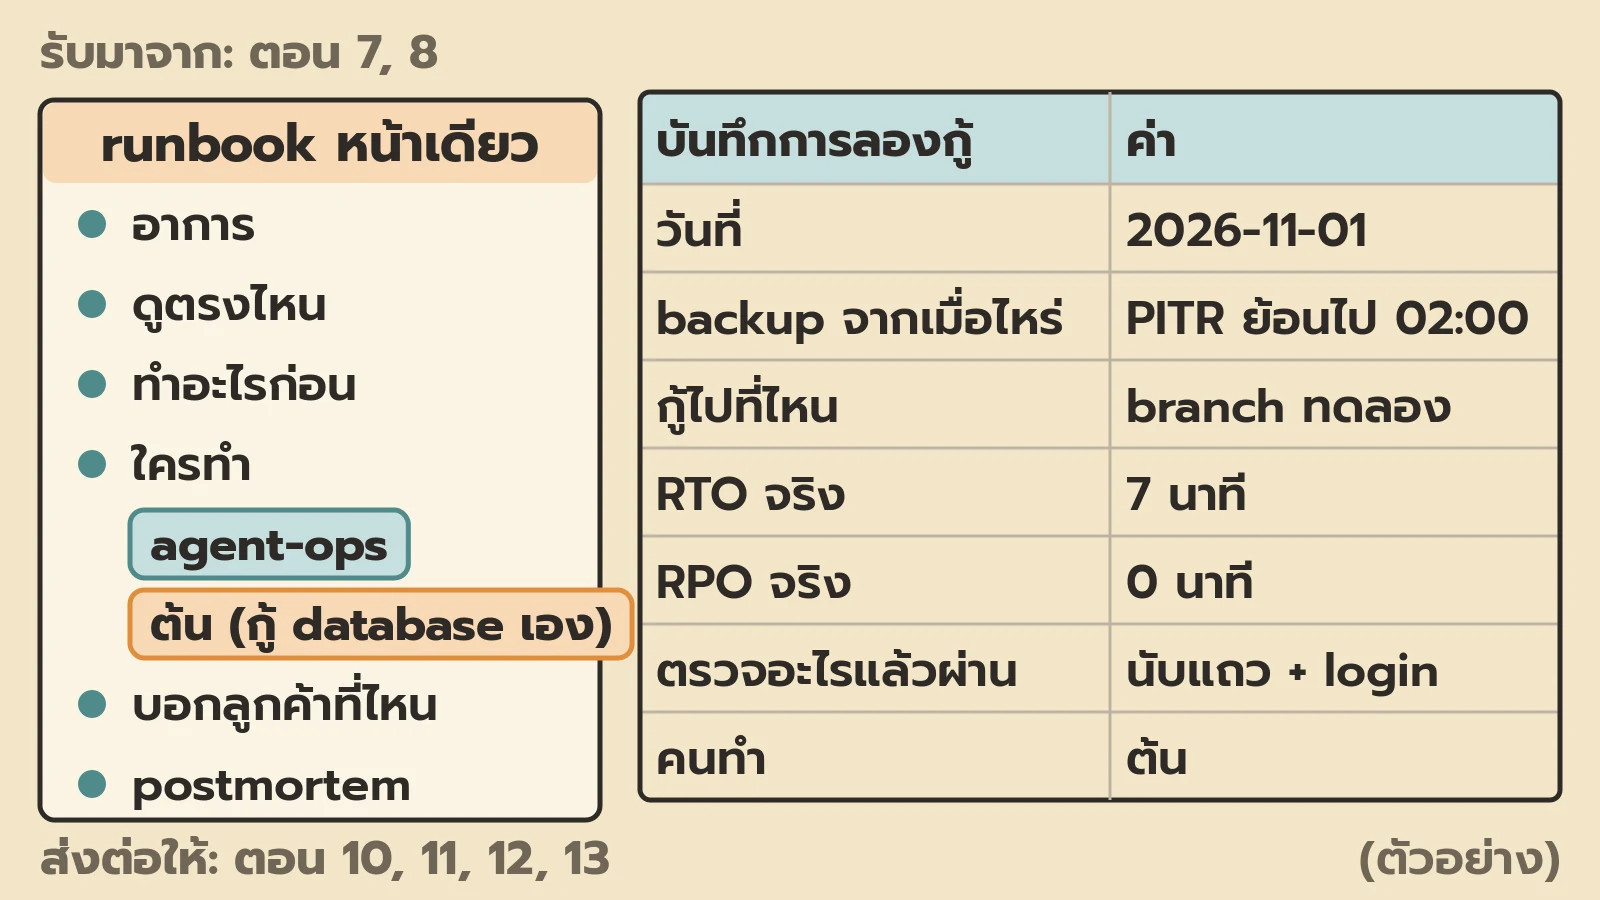
runbook และบันทึกการกู้ของต้นหน้าตาเป็นยังไง?
แถวหนึ่งใน runbook ของต้น (ตัวอย่าง):
| ช่อง | ค่า |
|---|---|
| อาการ | หน้า booking ตอบ 500 |
| ดูตรงไหน | Sentry และ health dashboard |
| ทำอะไรก่อน | ถ้าพังที่ build: redeploy build ก่อนหน้า / ถ้าพังที่ข้อมูล: หยุดการเขียน แล้วต้นกู้ด้วย PITR |
| ใครทำ | agent-ops ถอย build ได้ งาน database ต้นทำเอง |
| บอกลูกค้าที่ไหน | status page และ LINE OA |
| postmortem | เขียนภายใน 48 ชั่วโมง |
แถวหนึ่งในบันทึกการลองกู้ (ตัวอย่าง):
| ช่อง | ค่า |
|---|---|
| วันที่ | 2026-11-01 |
| backup จากเมื่อไหร่ | PITR ย้อนไป 02:00 |
| กู้ไปที่ไหน | branch restore-test-1101 |
| ใช้เวลา (RTO จริง) | 7 นาที |
| ข้อมูลหายย้อนไปแค่ไหน (RPO จริง) | 0 นาที |
| ตรวจอะไรแล้วผ่าน | นับแถว 3 ตาราง และ login ได้ |
| คนทำ | ต้น |
ลองเล่นคืนเดิมใหม่ (ตัวอย่าง):
03:12 หน้าจองพัง
03:14 alert health check ดังที่โทรศัพท์ต้น
03:16 agent-ops หยุดการเขียนข้อมูล แล้วเปิด runbook ขั้น 3 (ตัวอย่าง)
03:25 ต้นกู้ตารางด้วย PITR ไปที่ branch ทดลอง ตรวจแล้วสลับใช้ ระบบกลับมา (ตัวอย่าง)
มิวตื่นมาเจอข้อความสั้นๆ ว่าเมื่อคืนระบบล่ม 13 นาที และแก้แล้ว
มาตรฐานว่ายังไง
ISO/IEC 29110 ระดับ Basic เขียนไว้ว่า “A disciplined management process that provides project visibility and corrective actions of project problems and deviations is performed.” เรื่องนี้อยู่ในกระบวนการ Project Management
ISO/IEC/IEEE 12207 มี operation และ maintenance อยู่ในกลุ่ม Technical processes และมี risk management อยู่ในกลุ่ม Technical management
ISO/IEC 27001 ก็มีเรื่อง backup และการรับมือ incident อยู่ในภาคผนวก
ผมเทียบเอง: บริษัทใหญ่มีเวร on-call และ DR site ต้นมี alert 3 ตัว runbook หน้าเดียว และการลองกู้เดือนละครั้ง แต่ตอบคำถามเดียวกันสามข้อ: รู้ทันไหม ทำอะไรก่อน และกู้ได้จริงไหม
จิ๊กซอว์ชิ้นที่เติมแล้ว
ชิ้นที่ 8 เติมแล้ว ระบบบอกต้นก่อนลูกค้า และ backup ถูกพิสูจน์แล้วว่ากู้ได้
ชิ้นนี้ปิดช่วงที่ 2 เมื่อมีลูกค้าจริง
สิ่งที่ผมได้จากตอนนี้
ลองทำเอง
ใช้เวลาราว 30 ถึง 40 นาที ใช้ free tier และใช้ database ทดลองเท่านั้น (ตัวอย่าง)
- ตั้ง uptime หรือ health check ฟรีกับแอปทดลอง แล้วทำให้มันพัง จับเวลาว่า alert มาถึงเมื่อไหร่
- backup database ทดลองด้วย pg_dump หรือ PITR ของผู้ให้บริการ แล้วกู้ไปที่ database ใหม่ นับแถวเทียบกัน
- เขียน runbook หนึ่งแถวสำหรับอาการเดียว
ผมลองแล้ว: __ นาที ฿0 alert มาถึงใน __ นาที กู้ backup ใช้ __ นาที แถวตรงกัน / ขั้นที่ runbook ผิด: __
เก็บศัพท์
- observability: ความสามารถในการดูว่าระบบเกิดอะไรขึ้นจากข้างนอก
- alert: สัญญาณที่ระบบส่งมาบอกเราเมื่อมีอาการผิดปกติ
- health check: จุดที่ถามระบบว่ายังทำงานอยู่ไหม
- error rate: สัดส่วนคำขอที่ล้มเหลว
- runbook: หน้าที่บอกว่าเจออาการนี้ให้ทำอะไรทีละขั้น
- incident: เหตุที่ทำให้ลูกค้าใช้ระบบไม่ได้หรือใช้ได้ไม่ดี
- RTO: เวลาที่ยอมให้ใช้ในการกู้
- RPO: ช่วงข้อมูลที่ยอมให้หายย้อนหลัง
- PITR: การกู้ database ไปยังเวลาที่เลือก
- restore test: การลองกู้ backup จริงเพื่อพิสูจน์ว่าใช้ได้
- drill: การซ้อมรับมือก่อนวันจริง
- postmortem: บันทึกหลังเกิดเหตุ ว่าเกิดอะไร เพราะอะไร และจะแก้อะไร
- blameless: หาเหตุ ไม่หาคนผิด
จดบันทึก
backup นับเมื่อกู้ได้ และ alert ต้องดังก่อนลูกค้าทัก
ถ้าต้นเริ่มใหม่
ถ้าต้นเริ่มใหม่ เขาจะทำเรื่องนี้ตั้งแต่วันแรกไหม?
backup กับการลองกู้หนึ่งครั้ง: ทำ ก่อนมีลูกค้าจ่ายเงินคนแรก
alert 3 ตัว: ทำตั้งแต่วันแรก ใช้ราว 30 นาที ฿0 (ตัวอย่าง)
การซ้อมและ postmortem แบบเป็นทางการ: รอหลัง incident ครั้งแรก
ตอนต่อไป
เช้าวันหนึ่ง บิลค่า API สูงกว่าปกติสิบเท่า (ตัวอย่าง)
agent ตัวหนึ่งวนทำงานซ้ำทั้งคืน และไม่มีอะไรหยุดมัน
ตอนหน้า บริษัทของต้นเริ่มโต และเราจะได้เพดานค่าใช้จ่ายกับปุ่มหยุดที่ใส่ไว้ใน runbook
คำถามที่พบบ่อย
ผู้ให้บริการทำ backup ให้แล้ว ยังต้องลองกู้อีกไหม?
ต้อง GitLab มี backup ทุกวัน แต่คืนที่ต้องใช้กลับว่างเปล่า AWS เองก็แนะนำให้ลองกู้เป็นรอบ
ทำคนเดียว ต้องมี on-call ไหม?
ให้ alert เข้าโทรศัพท์ และเขียนไว้ว่าจะตอบลูกค้าภายในกี่ชั่วโมง ตอน 11 จะใส่เรื่องนี้ในเอกสาร support
agent แก้ incident เองได้ไหม?
ได้เฉพาะขั้นที่ runbook ให้ agent-ops ทำ การ restore ยังเป็นของต้น
postmortem ต้องเปิดเผยไหม?
ไม่จำเป็น แต่ข้อความสั้นๆ ถึงลูกค้าช่วยเรื่องความเชื่อใจ