สารบัญ
ทุกบทความในซีรีส์นี้มาจากการที่ผมคุยกับ AI แล้วค้นข้อมูลเพิ่มเติม ผมเป็นคนกำหนดทิศทาง ให้ AI ช่วยสรุป วิเคราะห์ และเรียบเรียงออกมาเป็นบทความครับ
ในตอนที่ 6 ทีมฝนปล่อยของใหม่ได้วันละหลายครั้ง
แล้วบ่ายวันหนึ่ง ปุ่มจ่ายเงินก็หายไปจากหน้าตะกร้า
test ผ่านหมด
ทีมรู้ตัวตอนลูกค้าโทรมาบ่น
ปล่อยเร็วได้แล้ว แต่ยังไม่รู้ว่าพังตอนไหน และฟื้นได้ช้า
ตอนนี้ขยับมาปี 2011
ปีที่เรื่องนี้จะเจ็บกว่าเดิมมาก
ฝน ร้าน และทุกคนในร้านยังเป็นตัวละครสมมติ แต่เครื่องมือและเหตุการณ์จริงที่เล่าถึง มีอยู่จริง
ปี 2011 วันที่ขายดีที่สุด กลายเป็นวันที่เว็บล่ม
วันลดราคาใหญ่ประจำปีของร้านอุปกรณ์เดินป่า
ฝนอายุ 41 แล้ว ยังเป็นหัวหน้าทีม
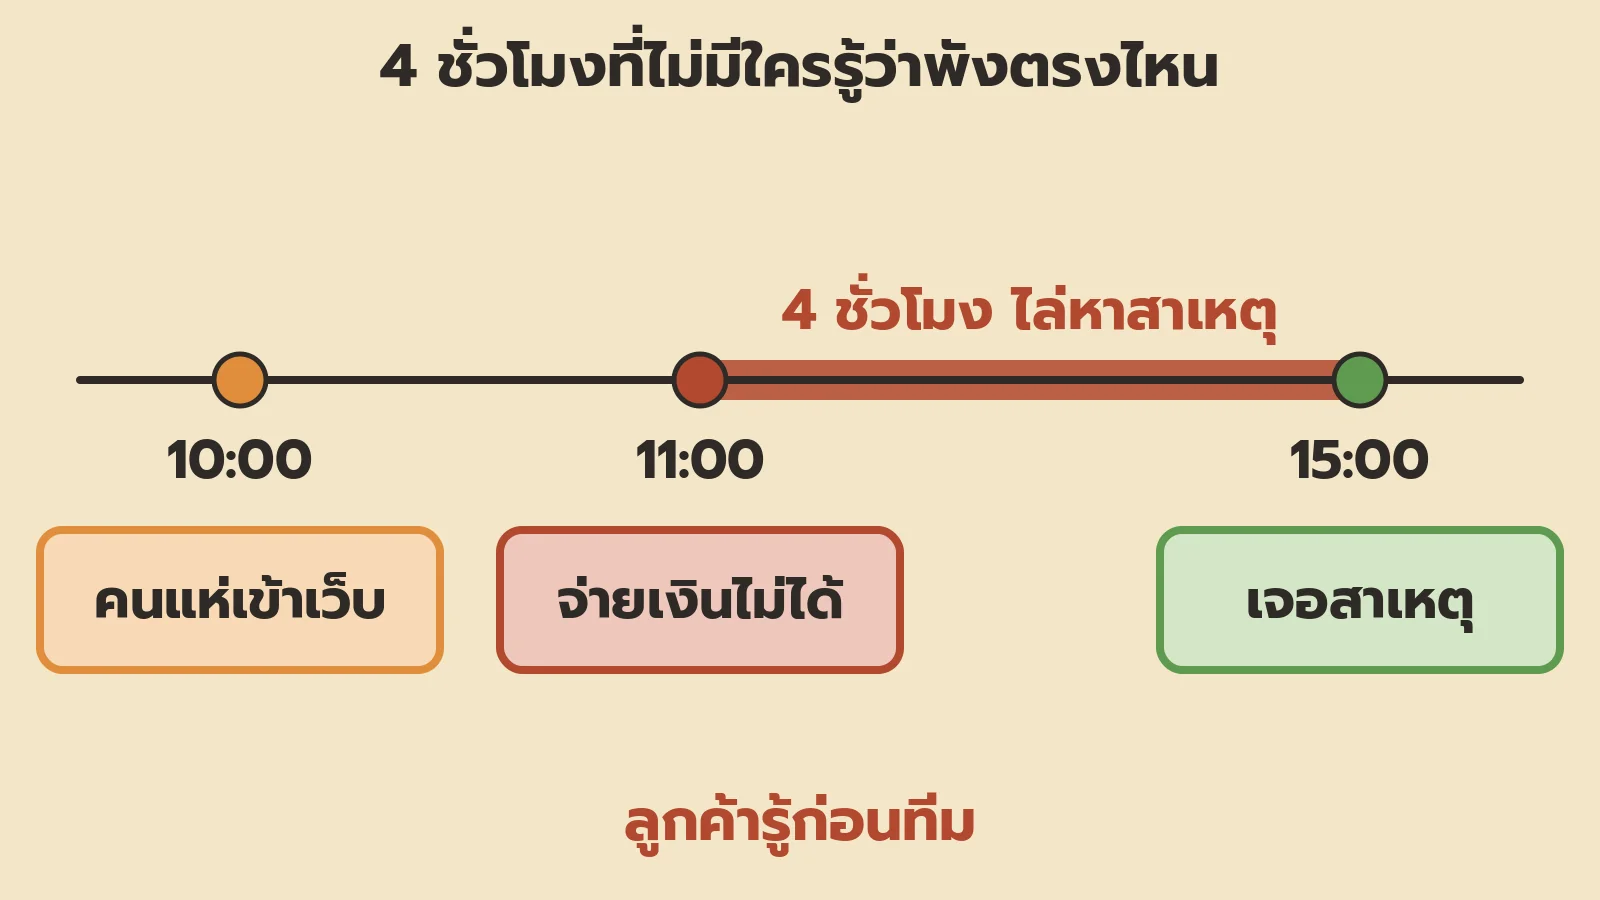
สิบโมงเช้า คนเข้าเว็บมากกว่าวันปกติหลายเท่า
สิบโมงครึ่ง เว็บเริ่มช้า
สิบเอ็ดโมง ลูกค้ากดจ่ายเงินไม่ได้
โทรศัพท์ร้านดังไม่หยุด
ทีมทั้งห้องรู้ว่าพัง แต่ไม่มีใครรู้ว่าพังตรงไหน
ฐานข้อมูลเต็ม? server ล้น? โค้ดที่เพิ่งปล่อยเมื่อเช้า? ระบบตัดบัตรของธนาคาร?
ทุกคนเปิดเครื่องตัวเอง ไล่อ่าน log ทีละไฟล์
กว่าจะเจอว่าเป็นตารางสต็อกสินค้าที่ทุกหน้าเรียกใช้พร้อมกันจนค้าง ก็บ่ายสามโมง
สี่ชั่วโมงในวันที่ขายดีที่สุดของปี
เจ้าของร้านเงียบไปทั้งวัน
ทำยังไงให้รู้ว่าพัง ก่อนลูกค้าจะโทรมา?
ให้เครื่องคอยวัดทุกส่วนของระบบตลอดเวลา แล้วปลุกคนทันทีที่ตัวเลขผิดปกติ
วิธีนี้เรียกว่า monitoring (คอยดูสุขภาพของระบบ) คู่กับ alert (แจ้งเตือน)
หลังวันนั้น ทีมฝนใช้เครื่องมือหลายตัว แต่ละตัวดูคนละเรื่อง
Nagios ถามทุกเครื่องว่ายังอยู่มั้ย
Nagios เริ่มจาก Ethan Galstad ปล่อยออกมาปี 1999 ในชื่อ NetSaint แล้วเปลี่ยนชื่อเป็น Nagios ในปี 2002
ทุกไม่กี่นาที มันจะเช็กว่า server แต่ละเครื่องยังตอบอยู่มั้ย พื้นที่เก็บข้อมูลใกล้เต็มหรือยัง
ถ้าไม่ตอบ ก็ส่งแจ้งเตือนทันที
Graphite กับ StatsD วัดได้ทุกอย่างเป็นกราฟ
Nagios บอกได้ว่าเครื่องยังอยู่
แต่บอกไม่ได้ว่าวันนี้ลูกค้าจ่ายเงินสำเร็จกี่ครั้ง
กุมภาพันธ์ปี 2011 ทีมของ Etsy เว็บขายของทำมือ เขียนเล่าว่าใช้ StatsD ตัวเล็กๆ ที่ตัวเองเขียน ส่งตัวเลขเข้า Graphite ให้วาดเป็นกราฟ
โค้ดบรรทัดเดียว อยากนับอะไรก็นับได้
ทีมฝนเลยนับทุกอย่าง กดจ่ายเงินสำเร็จกี่ครั้งต่อนาที หน้าตะกร้าเปิดช้าแค่ไหน
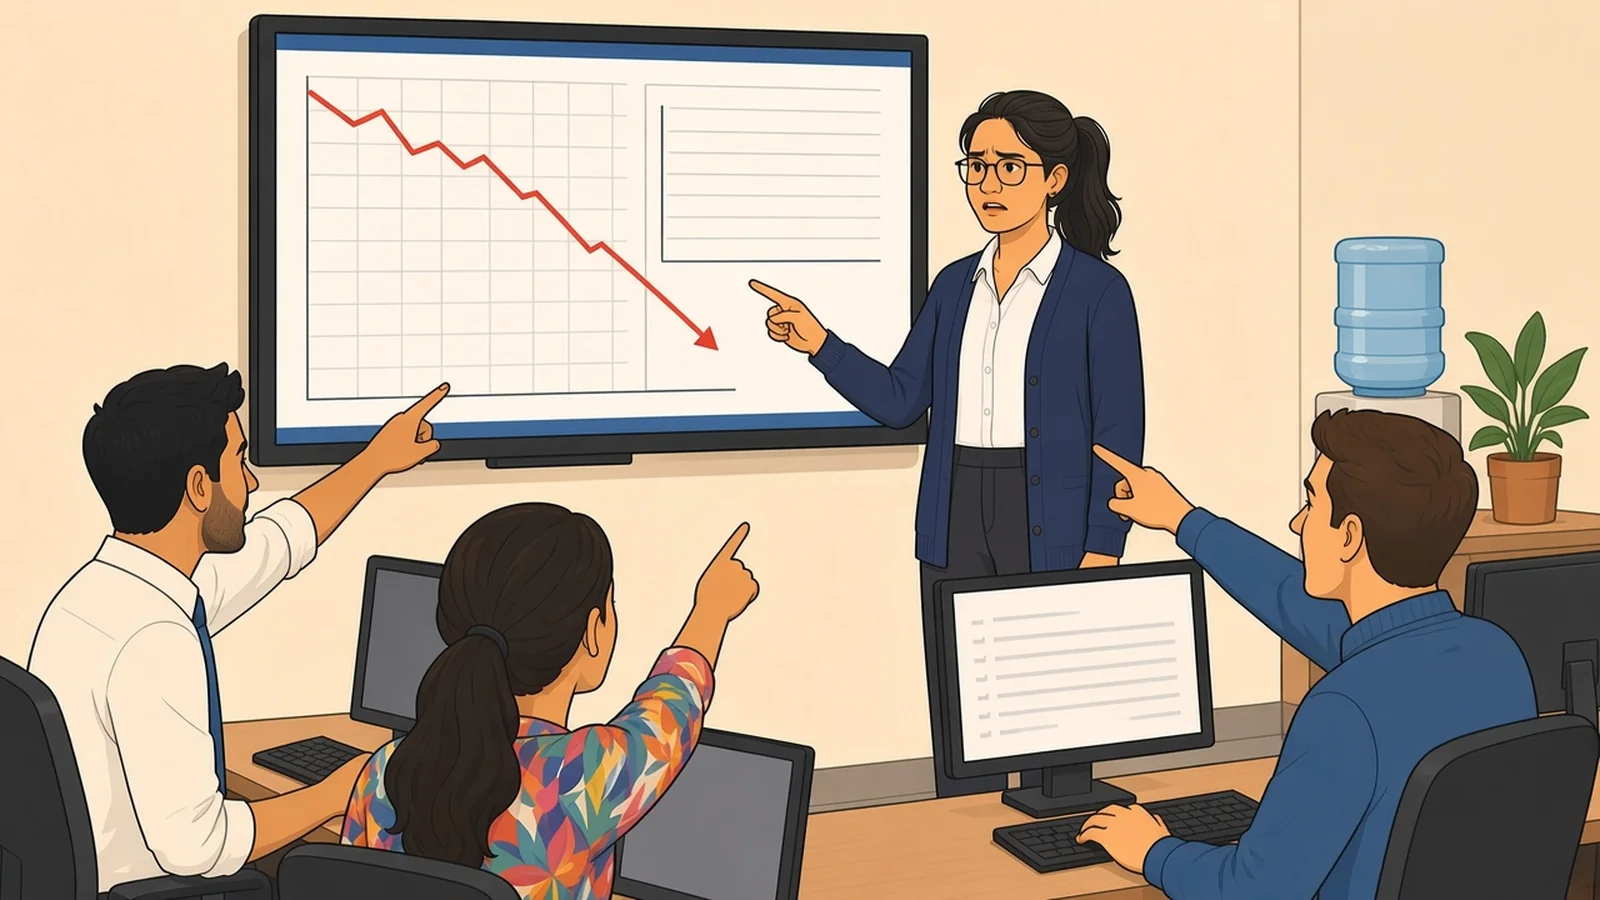
แล้วขึ้นกราฟบนจอใหญ่ที่ผนัง
ถ้ากราฟจ่ายเงินตกลงจากเดิมครึ่งหนึ่ง ทุกคนเห็นพร้อมกันในห้อง
New Relic บอกว่าโค้ดส่วนไหนช้า
กราฟบอกว่าหน้าตะกร้าช้า แต่ไม่บอกว่าช้าเพราะโค้ดบรรทัดไหน
New Relic ที่ก่อตั้งปี 2008 ช่วยตรงนี้
ติดตั้งไว้ในโปรแกรมร้าน แล้วมันจะแยกให้ดูว่าแต่ละครั้งที่ลูกค้าเปิดหน้า เวลาหมดไปกับส่วนไหน
ถ้าวันนั้นมี ทีมคงเห็นตั้งแต่สิบโมงครึ่งว่าเวลาเกือบทั้งหมด จมอยู่ที่ตารางสต็อก
Splunk ค้น log ได้เหมือนค้นเว็บ
วันเว็บล่ม ทุกคนไล่อ่าน log ทีละเครื่อง
Splunk ที่ปล่อยรุ่นแรกปี 2004 รวม log จากทุกเครื่องไว้ที่เดียว
พิมพ์ค้นได้เหมือนค้นเว็บ เช่น ค้นว่า “จ่ายเงินไม่สำเร็จ” ช่วงสิบโมงถึงสิบเอ็ดโมง
สี่ชั่วโมงที่ไล่หา อาจเหลือไม่กี่นาที
PagerDuty ปลุกคนเวร
แจ้งเตือนเยอะแค่ไหนก็ไม่มีประโยชน์ ถ้าไม่มีใครเห็น
โดยเฉพาะตอนตีสาม
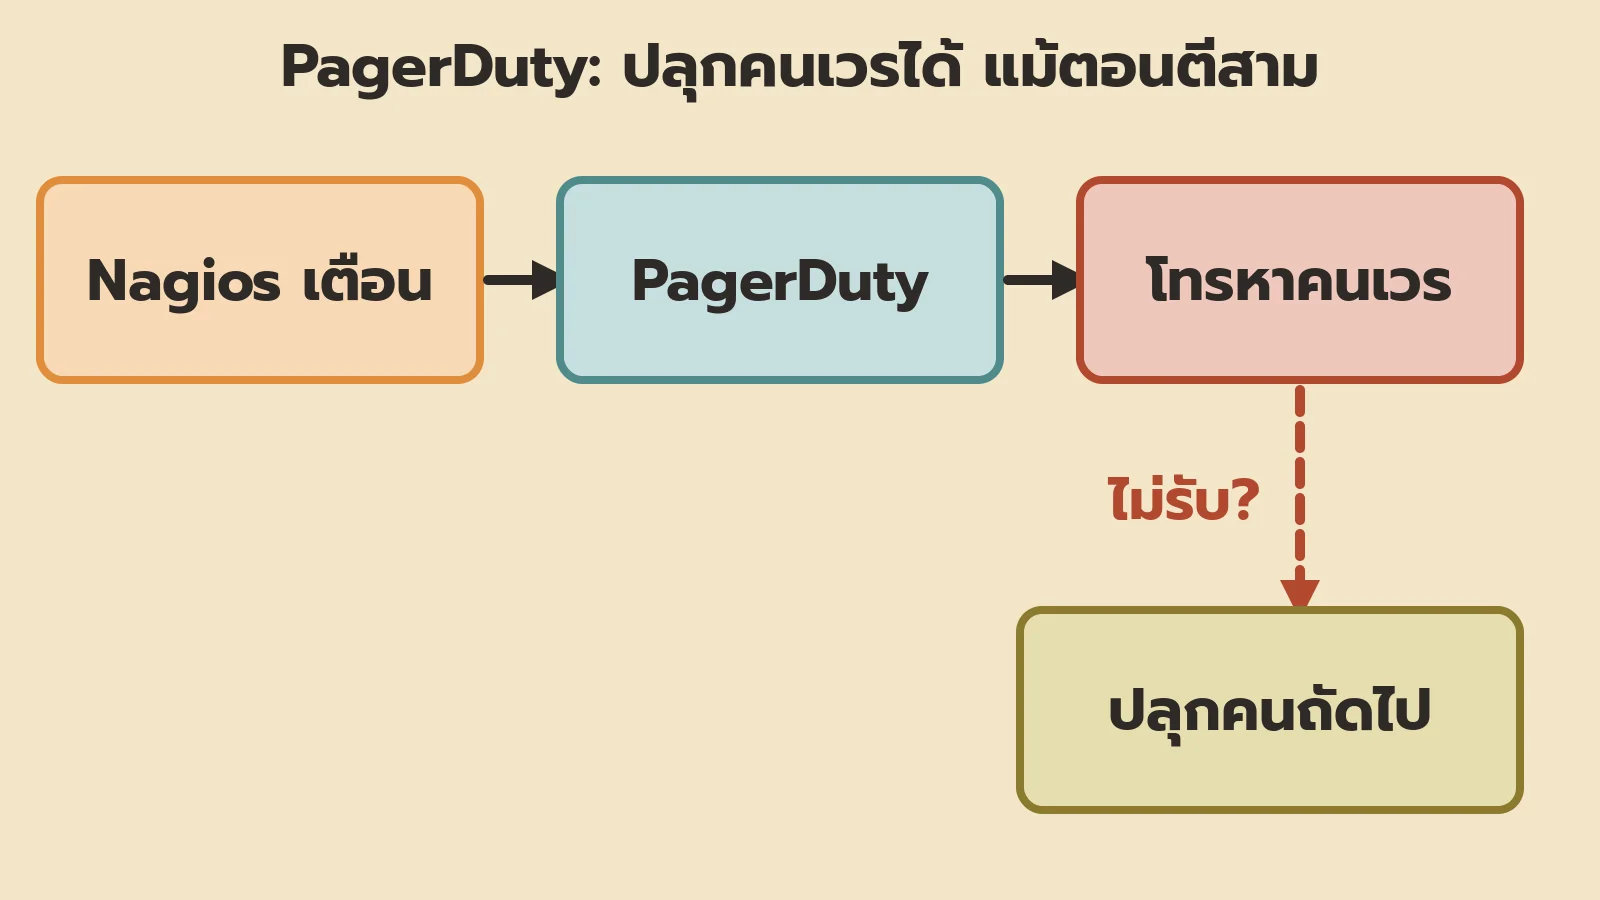
ทีมฝนจัดเวรกันในทีม สัปดาห์ละคน เรียกว่า on-call (คนที่ต้องพร้อมรับเรื่องนอกเวลางาน)
แล้วใช้ PagerDuty ที่เปิดตัวปี 2009 รับแจ้งเตือนจาก Nagios และตัวอื่นๆ ไปโทรปลุก ส่ง SMS หาคนเวร
ถ้าคนเวรไม่รับภายในไม่กี่นาที ก็ปลุกคนถัดไป
จะทำให้พังแค่ส่วนเดียว และฟื้นเร็วได้ยังไง?
แยกร้านเป็นชิ้นเล็กๆ ให้ชิ้นที่พังไม่ลากทั้งเว็บล่มตาม แล้วเตรียมปุ่มถอยกลับไว้ทุกครั้งที่ปล่อยของ
แยกร้านเป็นชิ้นเล็ก
วันเว็บล่ม ตารางสต็อกค้างตัวเดียว แต่ลากทั้งร้านลงไปด้วย
เพราะทั้งร้านเป็นโปรแกรมก้อนเดียว
ทีมฝนเลยค่อยๆ แยกออกเป็นโปรแกรมเล็กๆ หลายตัว เรียกว่า service
ตัวหนึ่งดูแลสต็อก ตัวหนึ่งดูแลตะกร้า ตัวหนึ่งดูแลการจ่ายเงิน ตัวหนึ่งดูแลรีวิวสินค้า
ถ้าส่วนรีวิวพัง หน้าสินค้าก็แค่ไม่โชว์รีวิว
ลูกค้ายังซื้อของได้ตามปกติ
ถอยกลับในคลิกเดียว
ในตอนที่ 6 ทีมฝนมีปุ่มเดียวไว้ปล่อยของใหม่
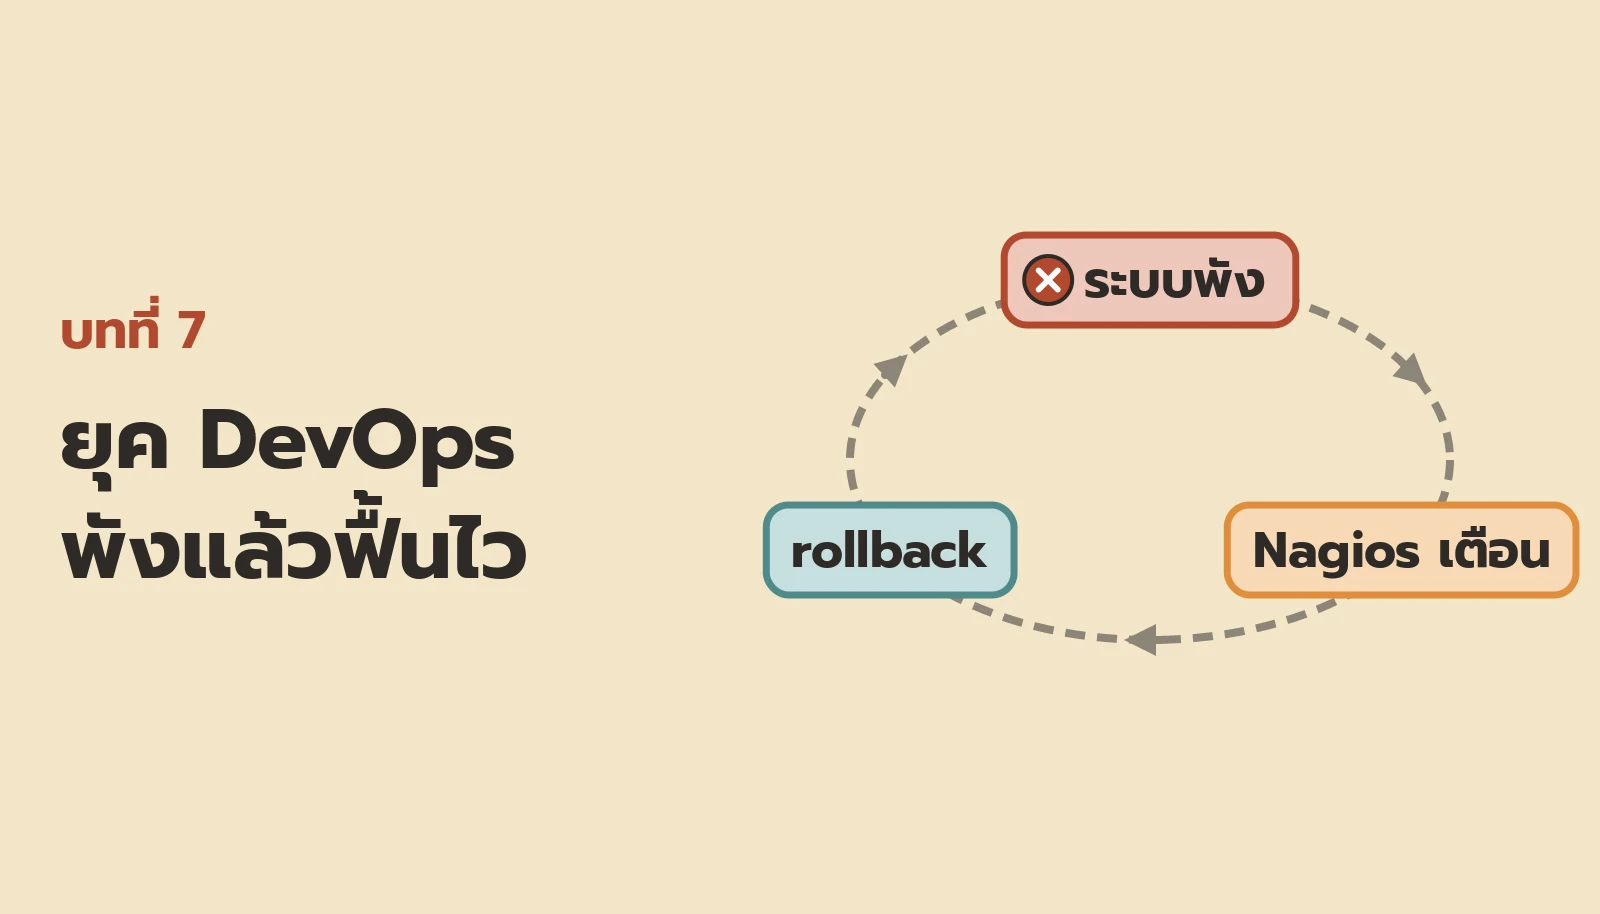
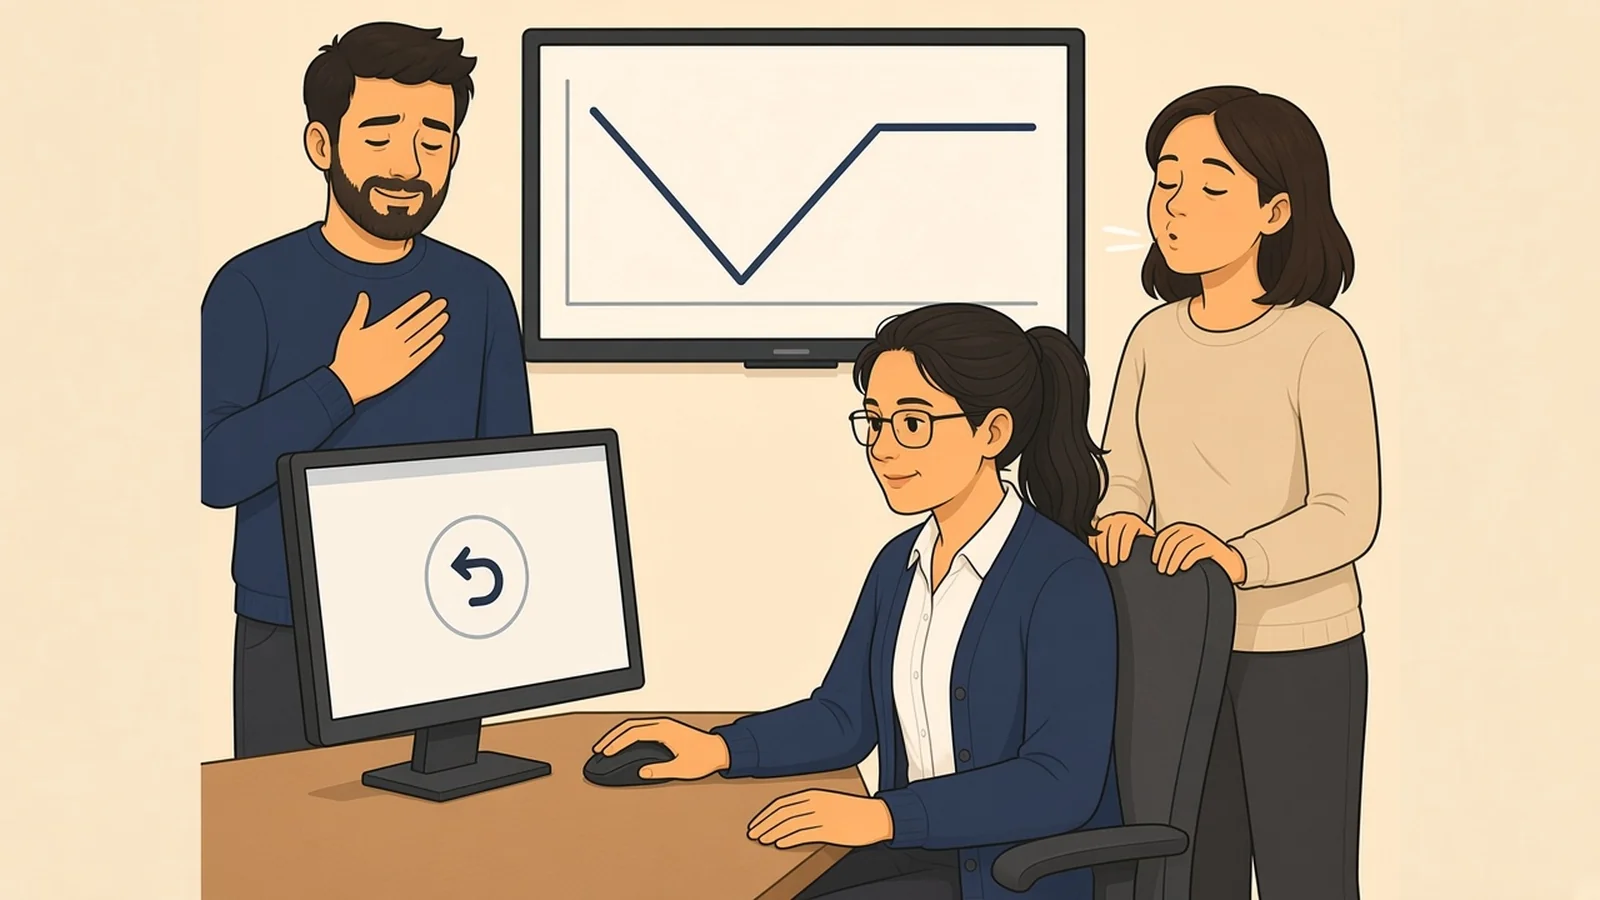
ตอนนี้เพิ่มอีกปุ่ม ไว้ถอยกลับไปรุ่นก่อนหน้า เรียกว่า rollback
ปล่อยของแล้วกราฟจ่ายเงินตก ไม่ต้องนั่งหาสาเหตุตอนนั้น
กดถอยก่อน ให้ลูกค้าซื้อของได้ แล้วค่อยหาว่าโค้ดผิดตรงไหน
ปุ่มจ่ายเงินที่หายไปในตอนที่ 6 ถ้ามีปุ่มนี้ ก็กลับมาภายในไม่กี่นาที
พังแล้ว เลิกถามว่าใครทำ
หลังวันเว็บล่ม เจ้าของร้านถามคำเดียว
“ใครทำ”
ถ้าตอบคำถามนี้ คนในทีมจะเริ่มซ่อนความผิด ไม่กล้าเล่าว่าเกิดอะไรขึ้นจริง
แล้วรอบหน้าก็พังแบบเดิมอีก
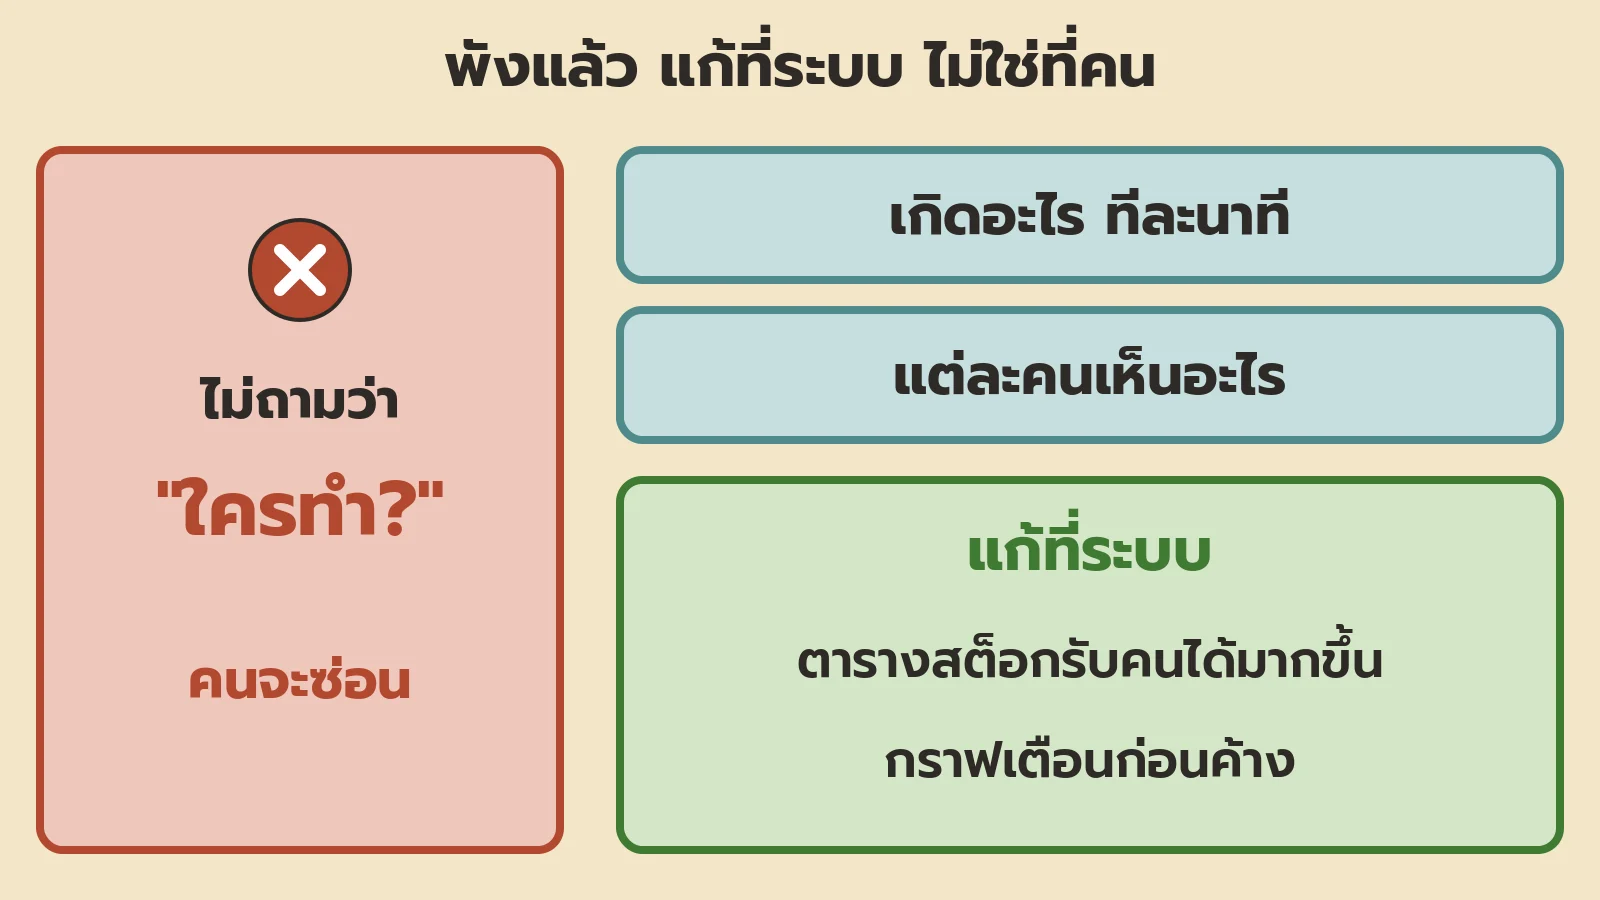
ทีมฝนเลยประชุมหลังเหตุการณ์แบบไม่หาคนผิด เรียกว่า blameless postmortem
ถามว่าเกิดอะไรขึ้นทีละนาที ตอนนั้นแต่ละคนเห็นอะไร ทำไมสิ่งที่ทำ ถึงดูสมเหตุสมผลในตอนนั้น
แล้วแก้ที่ระบบ ไม่ใช่ที่คน
เช่น ตารางสต็อกต้องรับคนพร้อมกันได้มากกว่านี้ และต้องมีกราฟเตือนก่อนมันค้าง
ปี 2012 John Allspaw จาก Etsy คนเดียวกับที่ขึ้นพูดเรื่อง Flickr ในตอนที่ 6 เขียนบทความเรื่องนี้ จนหลายบริษัทเอาไปใช้ต่อ
Netflix ปล่อยลิงไปพังระบบตัวเอง
มีบริษัทหนึ่งคิดไปไกลกว่านั้น
Netflix ย้ายระบบขึ้นไปเช่าเครื่องของ Amazon แล้วเขียนเครื่องมือชื่อ Chaos Monkey คอยสุ่มปิดเครื่องของตัวเองทิ้ง กลางวันในเวลางาน
ฟังดูบ้า 555+
แต่เหตุผลคือ เครื่องบน cloud พังได้ทุกเมื่ออยู่แล้ว ฝึกให้ระบบรอดตอนที่มีวิศวกรนั่งดูอยู่ ดีกว่าไปเจอตอนตีสาม
Netflix เล่าเรื่องนี้ไว้ตั้งแต่ปลายปี 2010
21 เมษายน 2011 Amazon มีปัญหาใหญ่ในศูนย์ข้อมูลฝั่งตะวันออกของอเมริกา หลายเว็บดังล่มไปตามกัน
Netflix ยังใช้งานได้ ช้าลงและ error มากกว่าปกติ แต่ลูกค้ายังดูหนังได้
ทีมฝนไม่ได้ปล่อยลิงแบบนั้น
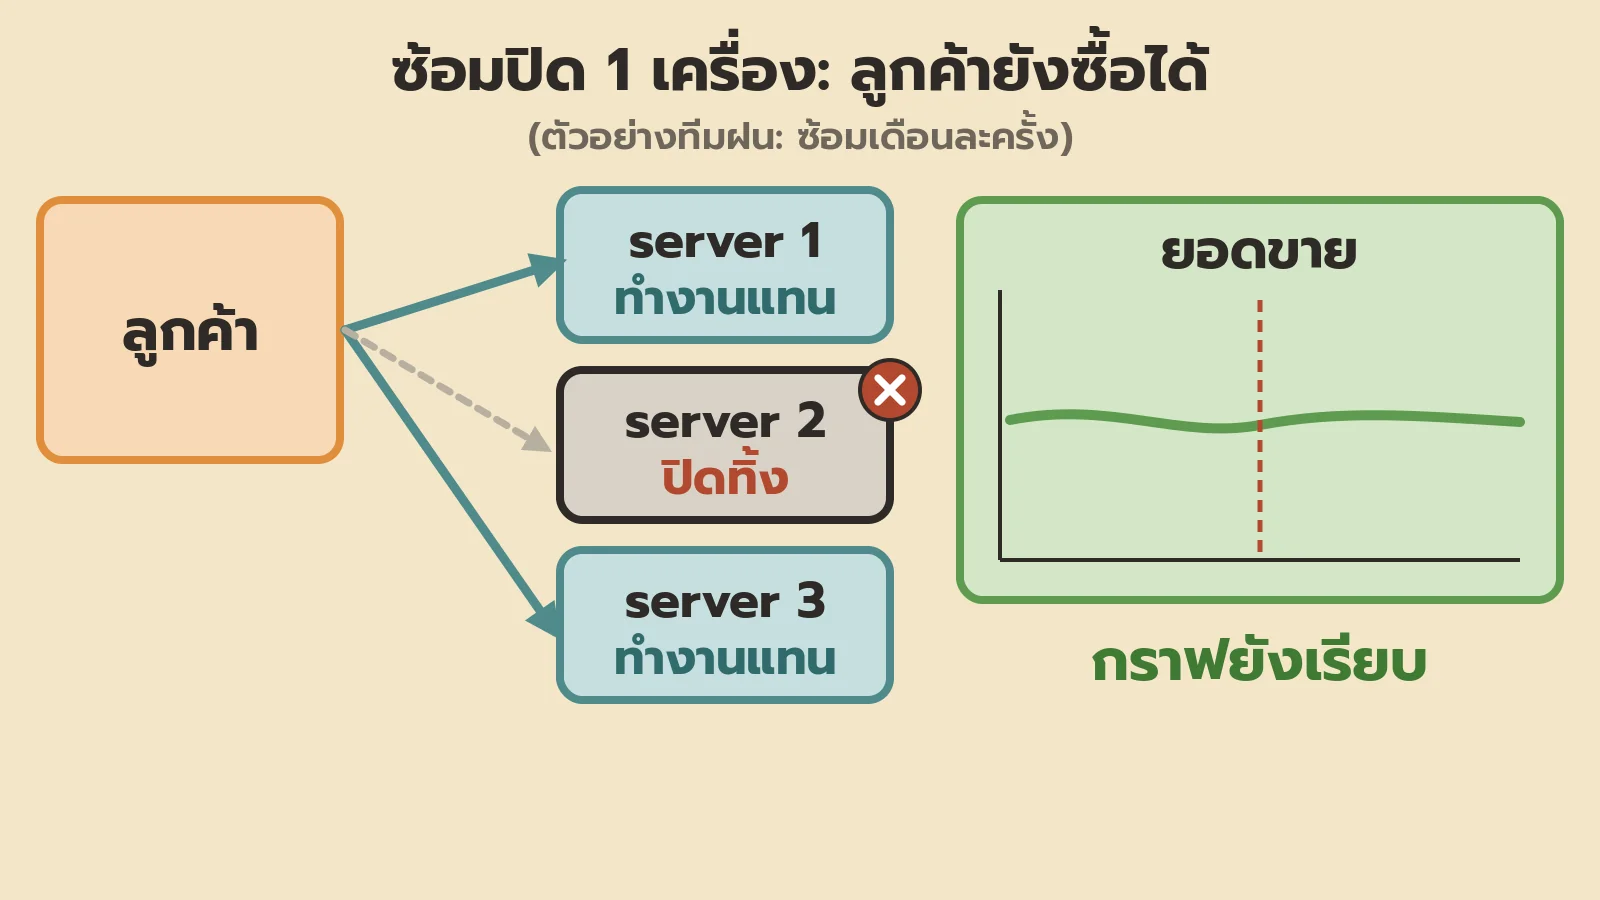
แต่เริ่มซ้อมปิด server ทิ้ง 1 ใน 3 เครื่อง เดือนละครั้ง ในวันธรรมดาตอนบ่าย ให้อีก 2 เครื่องรับลูกค้าแทน
ทุกวันนี้ เครื่องมือพวกนี้โตเป็นอะไร?
หลายตัวยังมีคนใช้อยู่ และมีตัวใหม่อย่าง Prometheus, Grafana กับ Datadog มาช่วยงานเดิมให้ง่ายขึ้น
ดูเป็นตารางสั้นๆ ไว้ต่อยอดครับ
| ยุคนั้น | ทุกวันนี้หลายทีมใช้ |
|---|---|
| Nagios (1999) | Prometheus (เริ่มที่ SoundCloud ปี 2012) |
| Graphite + StatsD (StatsD 2011) | Grafana (2014) |
| New Relic (2008) | New Relic ยังอยู่ และมี Datadog (2010) |
| Splunk (2004) | Splunk ยังอยู่ และมี Elasticsearch (2010) |
| PagerDuty (2009) | PagerDuty ยังอยู่ คู่กับการแจ้งเตือนเข้าห้อง chat ของทีม |
| Chaos Monkey (2010) | กลายเป็นแนวทางที่เรียกว่า chaos engineering มีบริษัทอย่าง Gremlin (2016) |
ทุกวันนี้คนเรียกรวมๆ ว่า observability คือมองเห็นข้างในระบบได้ จากตัวเลข log และเส้นทางของแต่ละคำขอ
สิ่งที่ผมได้จากยุคนี้
ลองทำเอง
ตามฝนมาตอนนี้ ผมว่าเรื่องสำคัญคือ พังแน่ไม่เป็นไร แต่ต้องรู้ก่อนลูกค้า และถอยกลับได้ทันที
ตัวเลขที่ทีมฝนดูไม่ใช่ “เว็บไม่เคยล่ม”
แต่เป็น “ล่มแล้วกลับมาได้ในกี่นาที”
เก็บศัพท์
| ศัพท์ | ความหมายแบบภาษาคน |
|---|---|
| monitoring | ให้เครื่องคอยวัดสุขภาพของระบบตลอดเวลา |
| alert | แจ้งเตือนเมื่อตัวเลขผิดปกติ |
| log | บันทึกว่าโปรแกรมทำอะไรไปบ้าง ทีละบรรทัด |
| on-call | คนเวรที่ต้องพร้อมรับเรื่องนอกเวลางาน |
| service | โปรแกรมเล็กๆ ที่ดูแลงานเรื่องเดียว แยกจากส่วนอื่น |
| rollback | ถอยกลับไปใช้รุ่นก่อนหน้า |
| blameless postmortem | ประชุมหลังเหตุการณ์ หาสาเหตุ ไม่หาคนผิด |
| Chaos Monkey | เครื่องมือของ Netflix ที่สุ่มปิดเครื่องทิ้ง เพื่อฝึกให้ระบบรอด |
| observability | มองเห็นข้างในระบบได้ จากตัวเลข log และเส้นทางของคำขอ |
จดบันทึก
ถ้าเพิ่งเข้ามาอ่านตอนนี้ ย้อนไปเริ่มที่ตอนที่ 1 ได้ครับ
ตอนที่ 2 สอนว่ายิ่งรู้ว่าผิดช้า ยิ่งเจ็บ
ตอนที่ 3 สอนว่ารอยต่อระหว่างคนคือที่ที่ความผิดซ่อนอยู่
ตอนที่ 4 สอนว่าให้คนใช้ดูเร็ว
ตอนที่ 5 ทำให้โค้ดเสร็จทุกสองสัปดาห์
ตอนที่ 6 ทำให้โค้ดถึงมือลูกค้าในวันเดียวกัน
ตอนนี้ทำให้พังแล้วรู้เร็ว และฟื้นเร็ว
ถึงตรงนี้ ทุกอย่างหลังเขียนโค้ดเสร็จ ทั้ง test ติดตั้ง เฝ้าดู แจ้งเตือน ถอยกลับ เครื่องทำให้หมดแล้ว
เหลืออย่างเดียวที่คนยังทำด้วยมือทุกบรรทัด
คือการเขียนโค้ดเอง
คำถามที่พบบ่อย
monitoring คืออะไร?
การให้เครื่องคอยวัดสุขภาพของระบบตลอดเวลา เช่น server ยังตอบมั้ย หน้าเว็บเปิดช้าแค่ไหน จ่ายเงินสำเร็จกี่ครั้ง แล้วแจ้งเตือนเมื่อตัวเลขผิดปกติ
observability ต่างจาก DevOps ยังไง?
DevOps คือวิธีทำงานที่ให้คนเขียนโค้ดกับคนดูแลเครื่องเป็นทีมเดียว และให้เครื่องทำงานซ้ำๆ แทนคน ส่วน observability เป็นเรื่องเดียวในนั้น คือการมองเห็นข้างในระบบ เพื่อรู้ว่าพังตรงไหนและเพราะอะไร
rollback คืออะไร?
การถอยกลับไปใช้รุ่นก่อนหน้าที่เคยทำงานได้ ให้ลูกค้าใช้ต่อได้ทันที แล้วค่อยหาสาเหตุทีหลัง
blameless postmortem คืออะไร?
การประชุมหลังระบบพัง ที่ถามว่าเกิดอะไรขึ้นและทำไม โดยไม่หาคนผิด เพื่อให้ทุกคนกล้าเล่าความจริง แล้วแก้ที่ระบบ
Chaos Monkey คืออะไร?
เครื่องมือของ Netflix ที่สุ่มปิดเครื่องของตัวเองทิ้งในเวลางาน เพื่อฝึกให้ระบบรอดได้เองเวลามีเครื่องพังจริง
Next → ตอนที่ 8: SDLC ครบวง งานผ่านใครบ้าง ตอนหน้าเป็นเรื่อง SDLC ครบวง ทุกอย่างหลังเขียนโค้ดเป็นงานของเครื่องหมดแล้ว แล้วถ้าการเขียนโค้ดเองก็มี AI มาช่วยด้วยล่ะ ทีมจะทำงานกันยังไง ผมจะลองดูครับ