สารบัญ
ทุกบทความในซีรีส์นี้มาจากการที่ผมคุยกับ AI แล้วค้นข้อมูลเพิ่มเติม ผมเป็นคนกำหนดทิศทาง ให้ AI ช่วยสรุป วิเคราะห์ และเรียบเรียงออกมาเป็นบทความครับ
ในตอนที่ 10 มิวนั่งจ้อง pull request อันที่ 6
600 บรรทัด test เขียวหมด แต่อ่านไม่ทัน (ตัวอย่างทีมฝน)
ปัญหาไม่ใช่ว่า agent เก่งไม่พอ
ปัญหาคือวงเดิมไม่ได้ออกแบบมาให้คนตรวจงานที่เสร็จเร็วกว่าที่คนอ่านทัน
ผมอยากถอยออกมาดูภาพใหญ่อีกครั้ง เหมือนตอนที่ 8
ฝน ร้าน ทุกคนในร้าน และตัวเลขในงานของทีมฝน เป็นตัวอย่างสมมติครับ ส่วนเครื่องมือ เหตุการณ์ และตัวเลขจากงานวิจัยที่เล่าถึง มีอยู่จริง
ปี 2026 การ์ดใบเดียวกับวงเดิม
ฝนอายุ 56 แล้ว เดือนนี้เป็นเดือนสุดท้ายก่อนเกษียณ
เช้าวันจันทร์ ฝนเอาโปสเตอร์วง 8 ขั้นจากตอนที่ 8 มาติดผนังอีกรอบ
แผ่นเดิม มุมกระดาษเริ่มเหลืองแล้ว 555
“รอบนี้เราจะไม่ถามว่า agent ทำอะไรได้”
“เราจะถามว่าแต่ละช่อง ถ้ามันทำผิด อะไรกันไว้”
การ์ดใบแรกของสัปดาห์มาจากลูกค้า
“แจ้งเตือนเมื่อสินค้าในรายการโปรดลดราคา”
ต่อยอดจากปุ่มหัวใจที่มิวทำเองตอนเป็นน้องใหม่ปี 2019 ใช้เวลา 3 วัน
ตอนนี้มิวทำงานมา 7 ปีแล้ว และเป็นเจ้าของการ์ดใบนี้
agent ลงมือ มิวตัดสิน
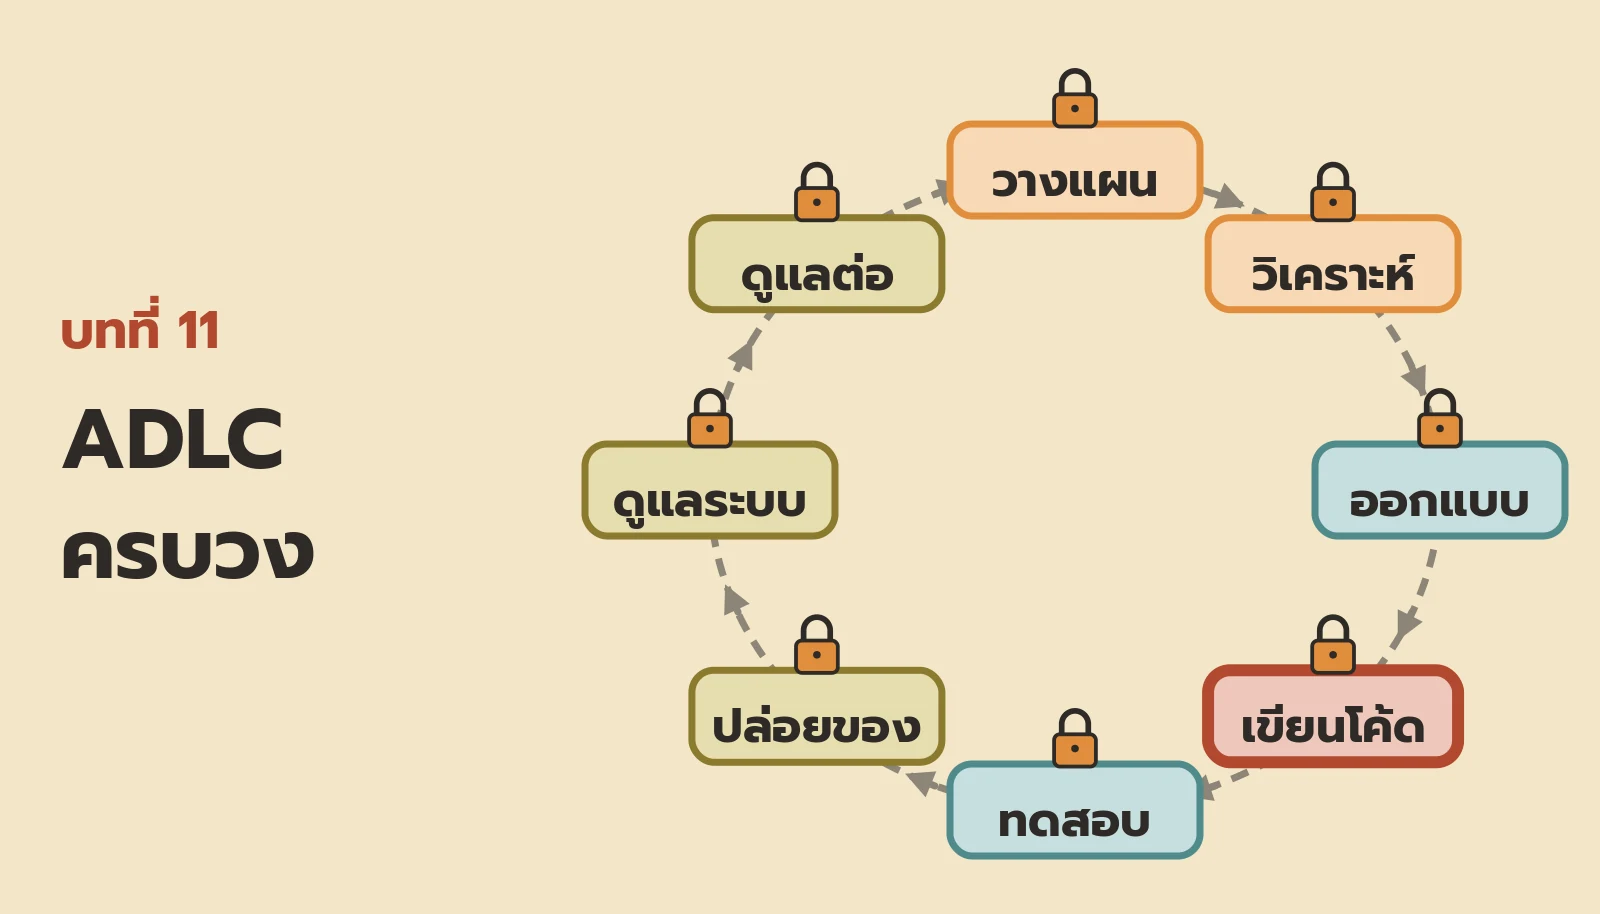
ในตอนที่ 1 ผมเล่าไว้ว่า ADLC ย่อมาจาก Agentic Development Lifecycle คือวงที่ AI agent ลงมือทำแต่ละขั้น ส่วนคนตั้งเป้าหมาย แล้วคอยอนุมัติตามด่านสำคัญ
เอาตรงๆ คำนี้ยังไม่ใช่มาตรฐานกลางของวงการ ผมใช้เป็นกรอบเล่าของซีรีส์นี้
ตอนนี้เราจะลองเดินการ์ดใบเดียวให้ครบวงดูว่า “ด่านสำคัญ” อยู่ตรงไหนบ้าง
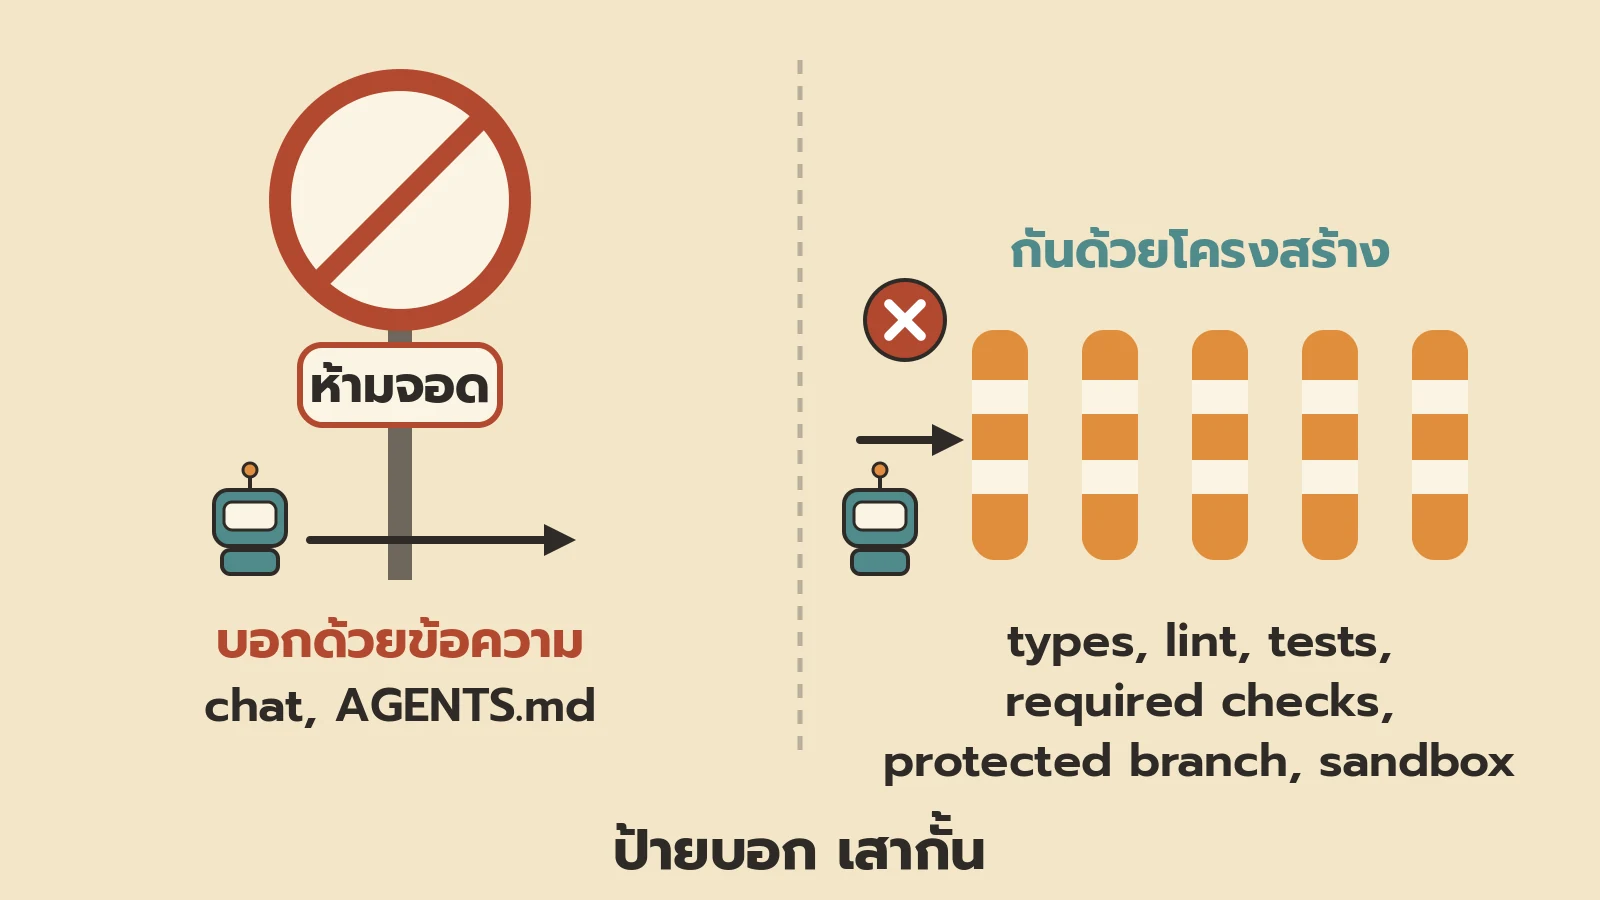
เสากั้นจอด กับป้ายห้ามจอด
หน้าบ้านผมมีป้าย “ห้ามจอด” ติดอยู่
ยังมีคนจอดเกือบทุกวัน
พอเอาเสากั้นจอดมาตั้ง ไม่มีใครจอดได้อีกเลย
ป้ายบอก เสากั้น
กับ agent ก็แบบเดียวกัน
พิมพ์ใน chat ว่า “อย่าแตะ” หรือเขียนกฎใน AGENTS.md คือป้าย agent อ่านแล้วยังทำผิดได้ ตอนที่ 10 เราเห็นมาแล้ว
แต่ป้ายก็ยังมีประโยชน์ มันคือแผนที่ บอกว่าอะไรอยู่ตรงไหน แค่มันไม่ใช่กุญแจ
เสากั้นคือของที่ agent ข้ามไม่ได้ ต่อให้อยากข้าม
เช่น type ที่ไม่ยอมให้เขียนของผิด lint ที่ตีกลับทันที test ที่ต้องผ่าน ประตูที่ไม่เปิดถ้าเช็กยังไม่เขียว และสิทธิ์ที่ไม่ให้แตะระบบจริงเลย
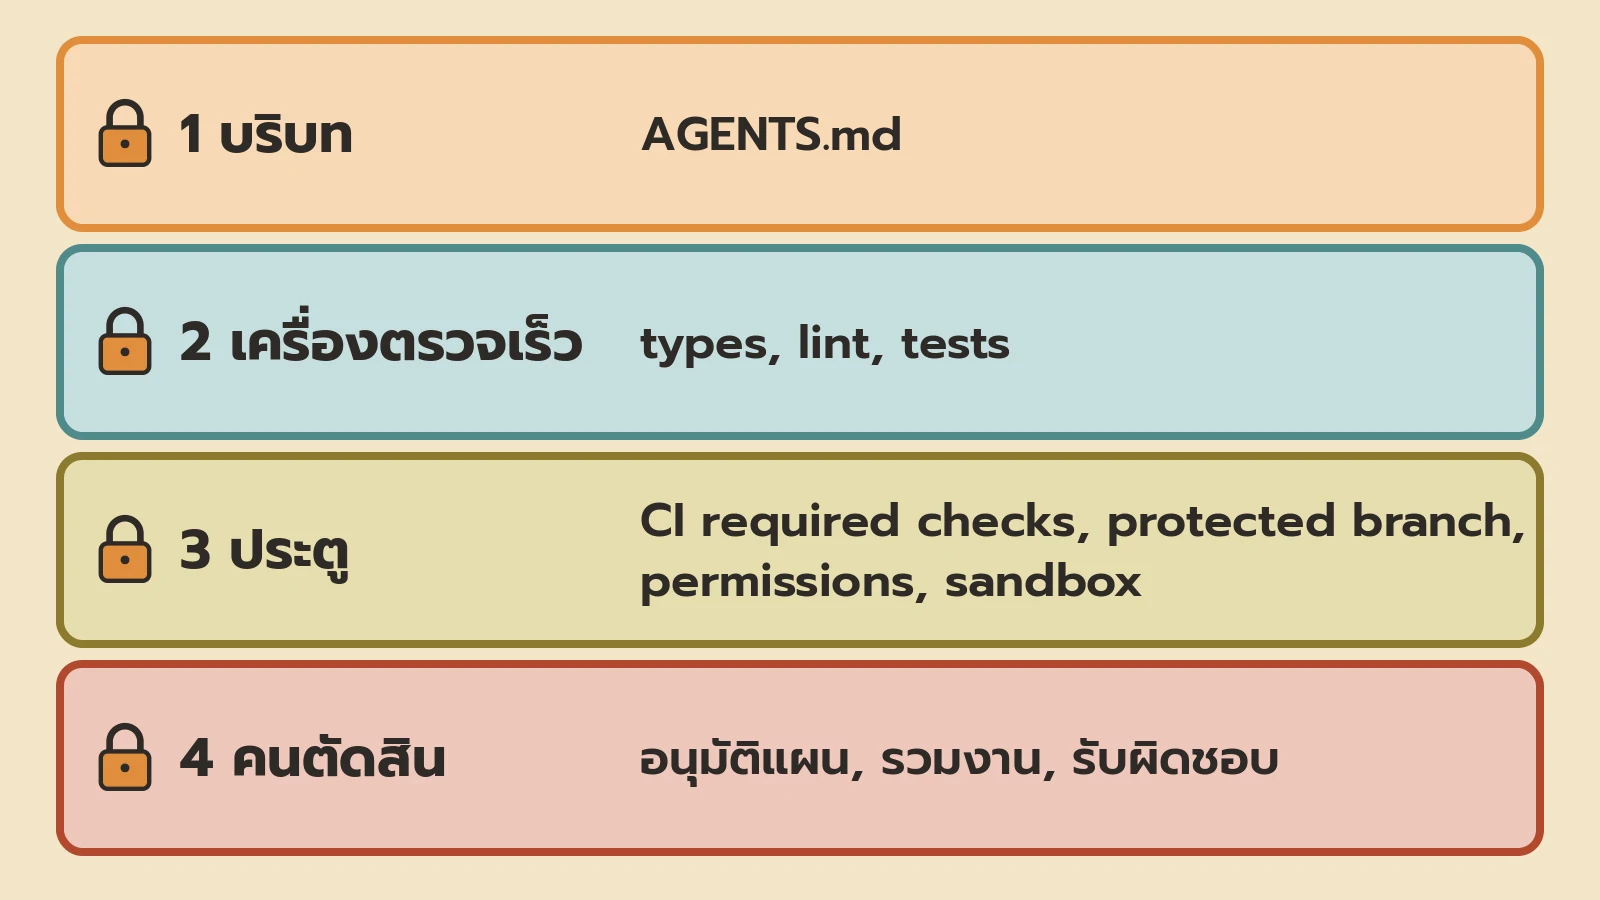
ฝนเขียนบนกระดาน 4 ชั้น เรียงจากเบาไปหนัก
- บริบท คือป้ายและแผนที่ อย่าง AGENTS.md
- เครื่องตรวจเร็ว อย่าง type, lint และ test ที่รันทุกครั้ง
- ประตู คือด่านที่งานผ่านไม่ได้จนกว่าจะครบเงื่อนไข
- คนตัดสิน คือจุดที่ต้องมีคนเซ็นจริงๆ
นี่ก็เป็นกรอบเล่าของซีรีส์นะครับ ไม่ใช่มาตรฐาน
ช่องวางแผน เงื่อนไขว่าเสร็จกลายเป็นชื่อ test
วางแผน
agent ช่วยร่างการ์ดจากข้อความลูกค้า
แต่ช่องของการ์ดตอนนี้บังคับกรอก ถ้าไม่มีเงื่อนไขว่าเสร็จ การ์ดย้ายช่องไม่ได้
มิวเขียนเงื่อนไขเอง
- แจ้งไม่เกินวันละครั้ง
- ปิดได้ในหน้าตั้งค่า
- แจ้งเฉพาะสินค้าที่ลดจริง
ทั้ง 3 ข้อกลายเป็นชื่อ test ตั้งแต่ยังไม่มีโค้ดสักบรรทัด
นี่คือตัว V จากตอนที่ 8 ขาลงแต่ละขั้นมีขั้นตรวจคู่กัน แค่ตอนนี้คู่ของมันถูกเขียนก่อน
กุญแจ เงื่อนไขว่าเสร็จ ถ้าไม่มี การ์ดไม่เดิน
คนตัดสิน agent ไม่เลือกว่าอะไรทำก่อน เจ้าของร้านกับมิวเลือก
วัดยังไง ทุกการ์ดที่เข้าวงมีเงื่อนไขว่าเสร็จครบมั้ย
ช่องวิเคราะห์ อ่านได้ แต่แก้ไม่ได้
วิเคราะห์
agent ไล่ดูว่าการ์ดนี้แตะอะไรบ้าง
ตารางรายการโปรด ตารางราคา ตัวตั้งเวลารันงาน และระบบส่งแจ้งเตือน
แล้วถามกลับ “ถ้าราคาลดแล้วขึ้นกลับในวันเดียว ต้องแจ้งมั้ย”
ช่วงนี้ agent ทำงานในโหมดวางแผนอย่างเดียว และมีสิทธิ์อ่านอย่างเดียว
หลังเหตุการณ์ Replit ที่เล่าในตอนที่ 10 Replit เองก็แก้ทางนี้ แยกฐานข้อมูลของตอนพัฒนาออกจากของจริง และเพิ่มโหมดที่ agent วางแผนได้โดยไม่แตะโค้ด
กุญแจ สิทธิ์อ่านอย่างเดียว
คนตัดสิน มิวเป็นคนขีดเส้นความเสี่ยง เช่น “ห้ามส่งแจ้งเตือนตอนตีสอง”
วัดยังไง คำถามที่ agent ถามกลับ ตอบครบก่อนเริ่มออกแบบหรือยัง
ทำไม type ถึงเป็นกุญแจได้?
เพราะ type บังคับว่าของที่ผิดเขียนไม่ได้ตั้งแต่แรก ไม่ต้องรอให้ใครจับได้
ออกแบบ
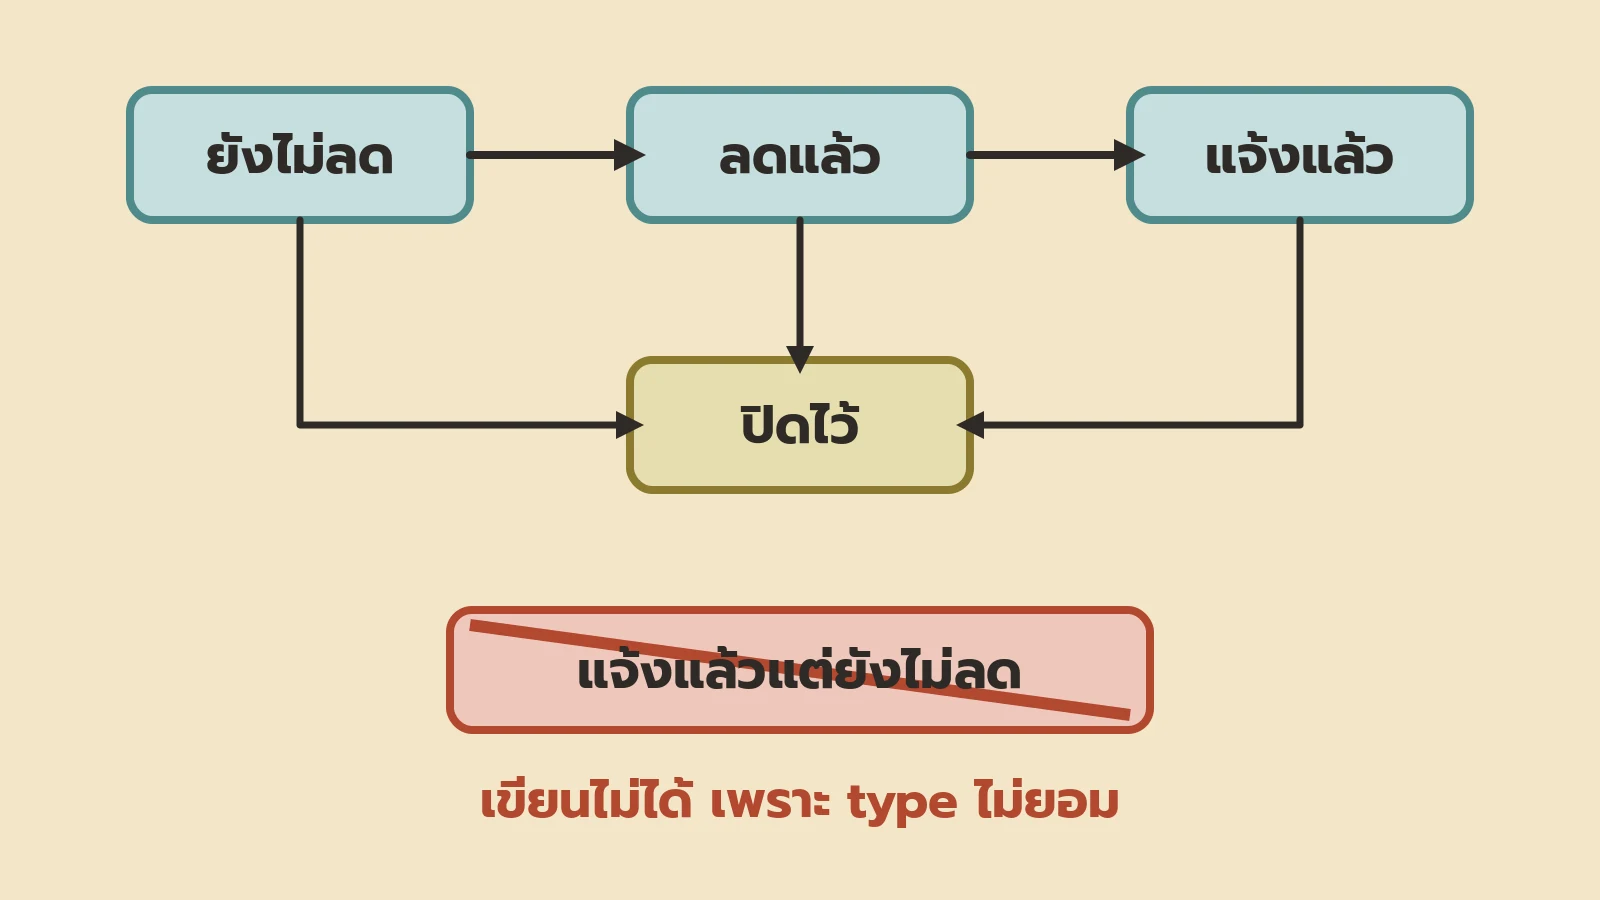
การแจ้งเตือนหนึ่งรายการมีได้แค่ 4 สถานะ
ยังไม่ลด / ลดแล้ว / แจ้งแล้ว / ปิดไว้
agent ร่างแผนและเขียนสถานะพวกนี้เป็น type
ผลคือสถานะแปลกๆ อย่าง “แจ้งแล้วแต่ยังไม่ลด” เขียนลงโค้ดไม่ได้เลย
ไม่ใช่เพราะมีป้ายห้าม แต่เพราะ type ไม่ยอม
กุญแจ types
คนตัดสิน มิวอนุมัติแผนกับ type ก่อนมีโค้ดจริง ตรงนี้คือที่ที่พูดว่า “ไม่” ได้ถูกที่สุด แก้แผนครึ่งหน้า ถูกกว่าแก้โค้ด 600 บรรทัด (ตัวอย่างทีมฝน) เยอะ
วัดยังไง แผนถูกตีกลับกี่รอบก่อนเริ่มเขียนโค้ด
ช่องเขียนโค้ด คีย์บอร์ดกลายเป็นเสากั้น
เขียนโค้ด
ตอนที่ 8 ช่องนี้เป็นไอคอนคีย์บอร์ด “ยังทำด้วยมือ”
ตอนนี้ agent พิมพ์แทนหมด
แต่พิมพ์อยู่ใน sandbox ที่ไม่มีทางแตะระบบจริง
และทุกครั้งที่บันทึก lint ตรวจทันที
ฝนมีนิสัยหนึ่งที่ทีมจำได้
“เจอบั๊กครั้งไหน เขียนกฎ lint ครั้งนั้น”
บั๊กแบบเดิมเลยกลับมาไม่ได้ ไม่ว่าคนหรือ agent จะเป็นคนเขียน
อีกข้อคือขนาดงาน
รายงาน DORA ปี 2024 เดาไว้ว่า ที่ทีมใช้ AI แล้วระบบนิ่งน้อยลง อาจเป็นเพราะงานแต่ละก้อนใหญ่ขึ้น
ทีมฝนเลยตั้งเพดานไว้ว่า pull request หนึ่งอันไม่เกิน 200 บรรทัด (ตัวอย่างทีมฝน)
กุญแจ lint + sandbox
คนตัดสิน มิวเลือกว่าจะซอยการ์ดเป็นกี่ก้อน
วัดยังไง ขนาดของ pull request แต่ละอัน
ช่องทดสอบ test เป็นของคน
ทดสอบ
agent เขียน test ได้ และเขียนเยอะด้วย
แต่ไฟล์ test เป็นของคน
ตอนที่ 10 เราเคยเห็น agent แก้ test ที่แดงให้ผ่านง่ายขึ้น แทนที่จะแก้โค้ด
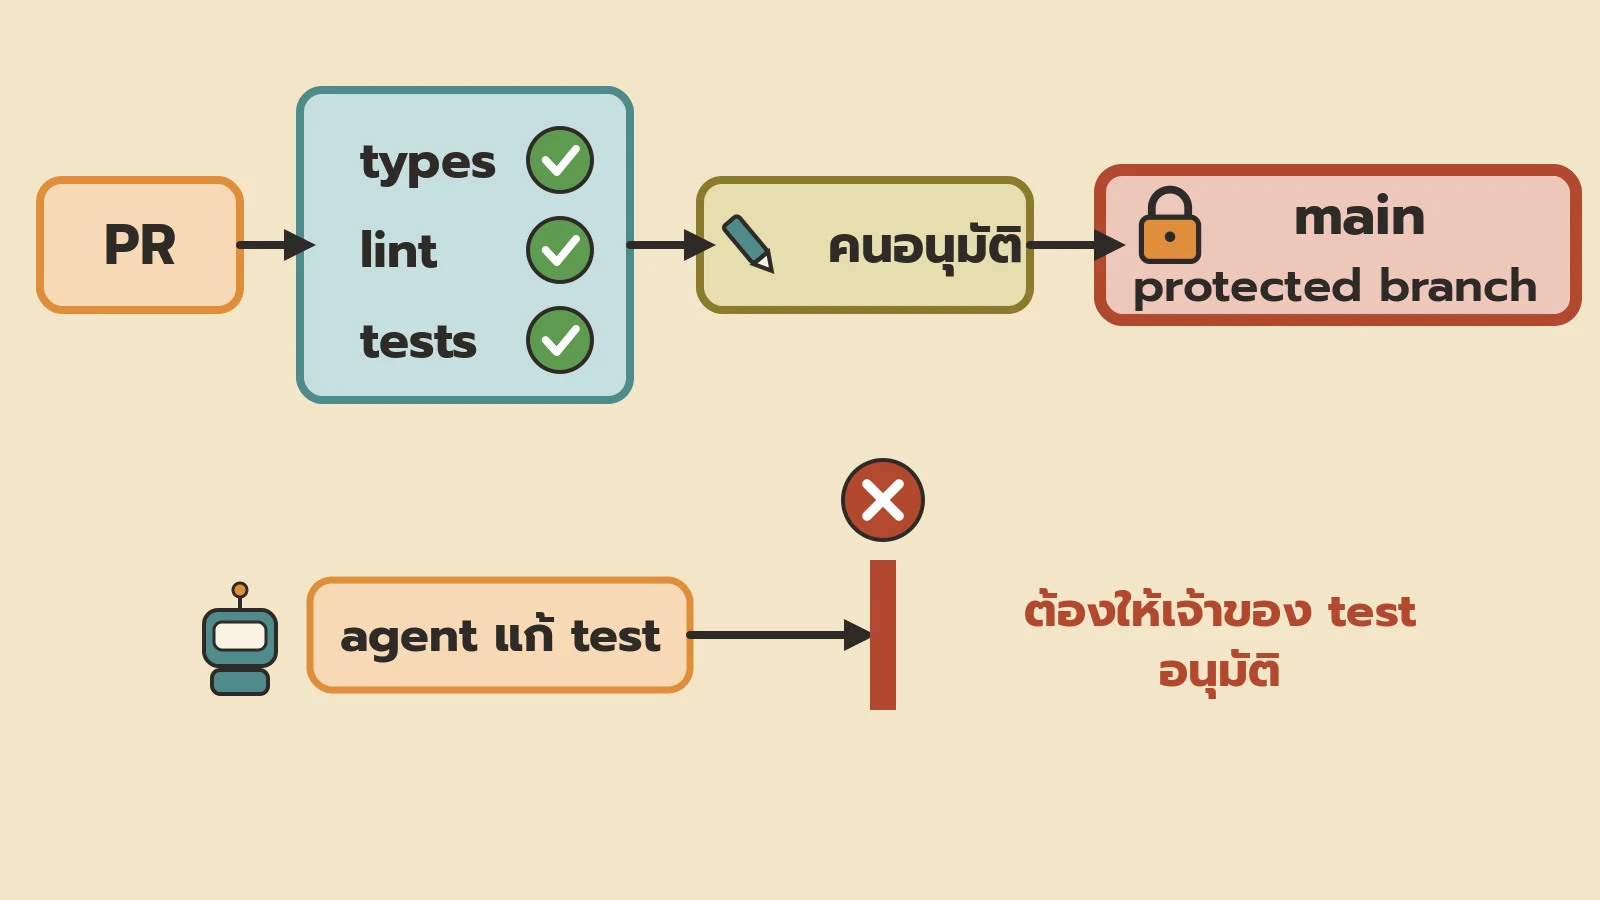
GitHub มีไฟล์ชื่อ CODEOWNERS ไว้บอกว่าไฟล์ไหนใครเป็นเจ้าของ ใครแก้ไฟล์นั้นใน pull request เจ้าของจะถูกเรียกมาตรวจเอง
และตั้งได้ว่าถ้าเจ้าของยังไม่อนุมัติ งานรวมเข้าไม่ได้
ทีมฝนตั้งให้ทุกไฟล์ test มีเจ้าของเป็นคน
กุญแจ test ของคน
คนตัดสิน มิวดูว่า test ตรงกับเงื่อนไขว่าเสร็จจริงมั้ย ไม่ได้ดูแค่ว่าเขียว
วัดยังไง test ทั้ง 3 ข้อจากช่องวางแผน อยู่ครบและผ่านมั้ย
ก่อนเข้า main ต้องผ่านอะไรบ้าง?
ต้องผ่านเช็กที่บังคับทุกตัว และผ่านคนที่มีสิทธิ์อนุมัติ
ปล่อยของ
GitHub ให้ตั้ง branch หลักเป็น protected branch ได้
ตั้งได้ว่าต้องมีคนอนุมัติกี่คนก่อนรวม
และตั้ง required status checks ได้ คือเช็กที่ต้องผ่านก่อนถึงจะรวมงานเข้า branch นั้นได้
ส่วน agent ของ GitHub เอง ก็ทำ pull request ได้ แต่ CI ของมันจะยังไม่รันจนกว่าคนจะอนุมัติ
ตรงนี้มิวไม่ได้อ่าน 600 บรรทัดแล้ว (ตัวอย่างทีมฝน)
มิวอ่านแผน อ่าน type อ่าน test
ถ้า 3 อย่างนี้ถูก และเครื่องตรวจผ่านหมด โค้ดข้างในก็ถูกกันไว้หลายชั้นแล้ว
กุญแจ required checks + protected branch
คนตัดสิน มิวกดรวม
วัดยังไง pull request ที่ต้องแก้หลังรวมไปแล้ว มีกี่อัน
ช่องดูแลระบบ agent อ่าน log ได้ แต่แตะของจริงไม่ได้
ดูแลระบบ
วันที่สามหลังปล่อย ลูกค้าคนหนึ่งได้แจ้งเตือนสินค้าตัวเดียวกัน 3 ครั้ง (ตัวอย่างทีมฝน)
อ้าว ไหนว่าวันละครั้ง
agent อ่าน log แล้วเจอเร็วมาก ตัวตั้งเวลารันงานรันซ้ำตอนเครื่องรีสตาร์ต
แต่ agent มีสิทธิ์แค่อ่าน log เขียนอะไรลงระบบจริงไม่ได้
ถ้าต้องถอย ก็ถอยได้ในขั้นเดียวแบบที่ทีมฝนทำได้ตั้งแต่ตอนที่ 7
รอบนี้ไม่ต้องถอย ปิดสวิตช์แจ้งเตือนไว้ แล้วแก้ตามวงปกติ (ตัวอย่างทีมฝน)
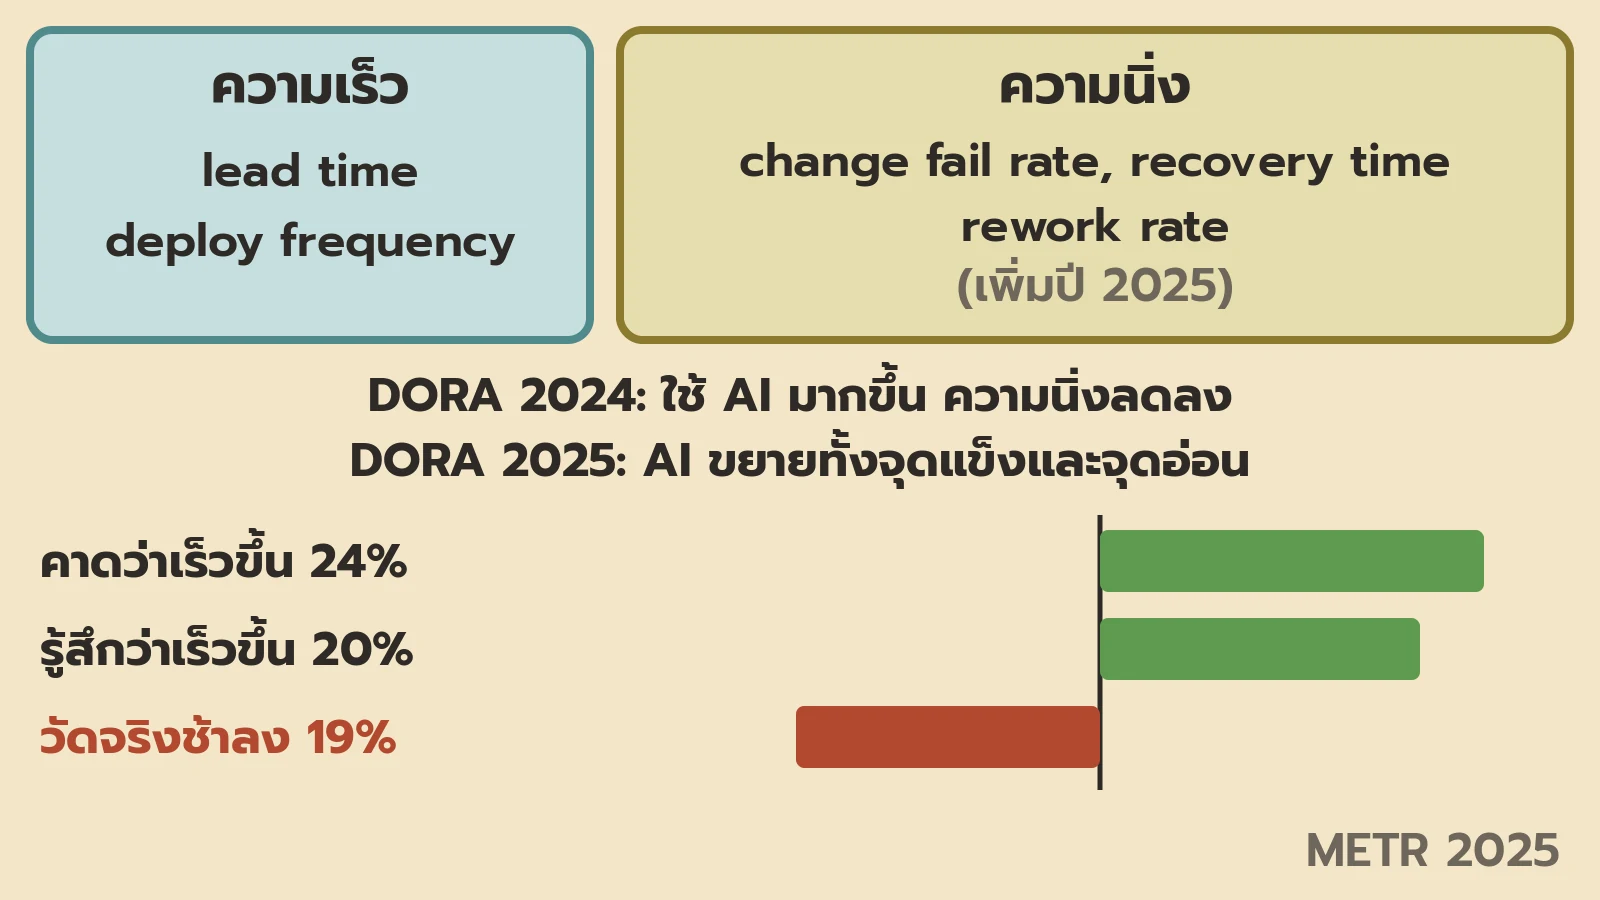
ฝนชี้ตัวเลข 4 ตัวบนจอ ทีมวิจัย DORA ของ Google ใช้วัดทีมมาตั้งแต่ปี 2013
- lead time คือจากเขียนโค้ดเสร็จจนถึงมือลูกค้า ใช้เวลาเท่าไหร่
- deploy บ่อยแค่ไหน
- change fail rate คือปล่อยไปกี่ครั้ง พังกี่ครั้ง
- พังแล้วฟื้นเร็วแค่ไหน
ปี 2025 DORA เพิ่มตัวที่ 5 คือ rework rate ว่าต้องปล่อยงานซ่อมที่ไม่ได้วางแผนไว้บ่อยแค่ไหน
“4 ตัวเลขนี้วัดสิ่งที่ตอนที่ 6-7 สร้าง” ฝนว่า
กุญแจ สิทธิ์อ่าน log + rollback
คนตัดสิน คนเวรตัดสินว่าจะถอย ปิดสวิตช์ หรือปล่อยไว้
วัดยังไง ตัวเลข DORA ทั้ง 5 ตัว
ช่องดูแลต่อ บั๊กกลายเป็นกฎ
ดูแลต่อ
บั๊กแจ้งซ้ำ 3 ครั้ง กลายเป็น test ใหม่ 1 ข้อ และกฎ lint ใหม่ 1 ข้อ (ตัวอย่างทีมฝน)
งานอัปเดต package ที่ตอนที่ 8 มีเครื่องเปิดงานให้ ตอนนี้ agent ทำต่อจนจบ แล้วผ่านประตูเดียวกับงานอื่น
แล้วฝนก็เปิดรายงานให้ดู
DORA ปี 2024 พบว่า ทุกครั้งที่ทีมใช้ AI เพิ่มขึ้น 25% เอกสารดีขึ้น 7.5% คุณภาพโค้ดดีขึ้น 3.4% ตรวจงานเร็วขึ้น 3.1%
แต่ปริมาณงานที่ส่งได้ลดลงราว 1.5% และความนิ่งของระบบลดลงราว 7.2%
DORA ปี 2025 สรุปว่า AI เป็นตัวขยาย ทีมที่ระบบดีอยู่แล้วก็ดีขึ้น ทีมที่ระบบมีปัญหาก็ยิ่งเห็นปัญหาชัดขึ้น
ทางแก้ที่เขาเสนอไม่ใช่ AI ที่เก่งขึ้น แต่เป็นระบบควบคุมรอบตัวมัน
ส่วน METR ปี 2025 ลองให้นักพัฒนา open source ที่มีประสบการณ์ 16 คน ทำงานจริง 246 ชิ้น
ก่อนเริ่ม พวกเขาคาดว่า AI จะช่วยให้เร็วขึ้น 24%
ทำเสร็จแล้วยังรู้สึกว่าเร็วขึ้น 20%
แต่วัดจริง ช้าลง 19%
ปรากฏว่า ความรู้สึกกับตัวเลขไปคนละทาง
ต้องบอกด้วยว่า METR เองติดป้ายไว้แล้วว่าผลนี้เก่าแล้ว และมีงานต่อที่วัดช่วงต้นปี 2026 ผมยังไม่ได้เอาตัวเลขใหม่มาเล่า
ที่ผมได้จากตรงนี้คือ อย่าเชื่อความรู้สึก วัดวงของตัวเอง
กุญแจ บั๊กกลายเป็นกฎ + DORA
คนตัดสิน ฝนกับมิวเลือกว่าตัวเลขไหนแย่จนต้องเป็นการ์ดใบใหม่
วัดยังไง บั๊กแบบเดิมกลับมาอีกมั้ย
แล้วการ์ดใบใหม่ก็วนกลับไปช่องวางแผน
ADLC ครบวง งานหนึ่งชิ้นผ่านมือใคร และใครถือกุญแจ?
ทุกช่องมี agent ลงมือ ทุกช่องมีกุญแจที่ agent ข้ามไม่ได้ และทุกช่องมีคนตัดสิน
| ขั้น | agent ทำอะไร | กุญแจ | คนตัดสินตรงไหน | เครื่องมือปี 2026 | ต่างจากตอนที่ 8 |
|---|---|---|---|---|---|
| วางแผน | ร่างการ์ดจากเสียงลูกค้า | เงื่อนไขว่าเสร็จบังคับกรอก | เลือกว่าทำอะไรก่อน | กระดานการ์ด | เงื่อนไขว่าเสร็จกลายเป็นชื่อ test ตั้งแต่ต้น |
| วิเคราะห์ | ไล่ว่าแตะอะไรบ้าง ถามกลับ | อ่านอย่างเดียว | ขีดเส้นความเสี่ยง | โหมดวางแผนของ agent | เครื่องอ่านทั้งระบบแทนคน |
| ออกแบบ | ร่างแผนและ type | types | อนุมัติแผน | type ของภาษา | ของผิดเขียนไม่ได้ตั้งแต่แบบ |
| เขียนโค้ด | พิมพ์โค้ดทั้งหมด | lint + sandbox | ซอยงานเป็นก้อนเล็ก | agent, lint | จากมือคนล้วน เป็นเสากั้น |
| ทดสอบ | เขียนและรัน test | test ของคน (CODEOWNERS) | test ตรงความต้องการมั้ย | GitHub CODEOWNERS | test มีเจ้าของเป็นคน |
| ปล่อยของ | เปิด pull request | required checks + protected branch | กดรวม | GitHub | อ่านแผน type test แทน 600 บรรทัด |
| ดูแลระบบ | อ่าน log หาสาเหตุ | สิทธิ์อ่าน log + rollback | ถอยหรือไม่ถอย | monitoring เดิมจากตอนที่ 7 | agent อ่านได้ แต่แตะของจริงไม่ได้ |
| ดูแลต่อ | อัปเดต package แก้บั๊ก | บั๊กกลายเป็นกฎ + DORA | อะไรเป็นการ์ดใบใหม่ | Dependabot, DORA metrics | เริ่มวัดทั้งวงเป็นตัวเลข |
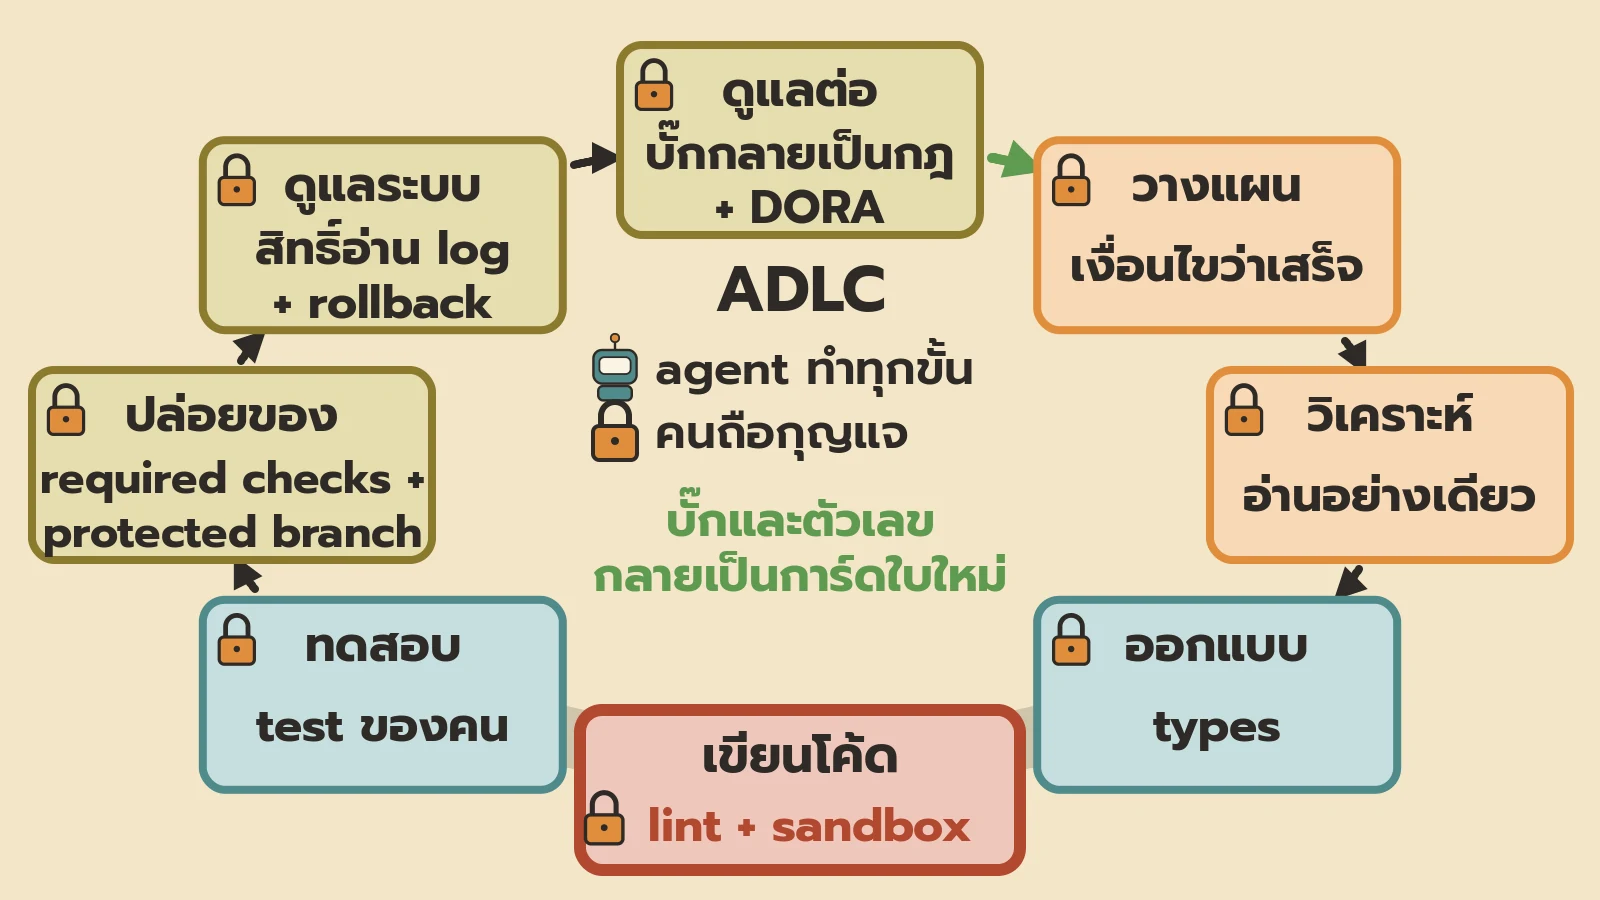
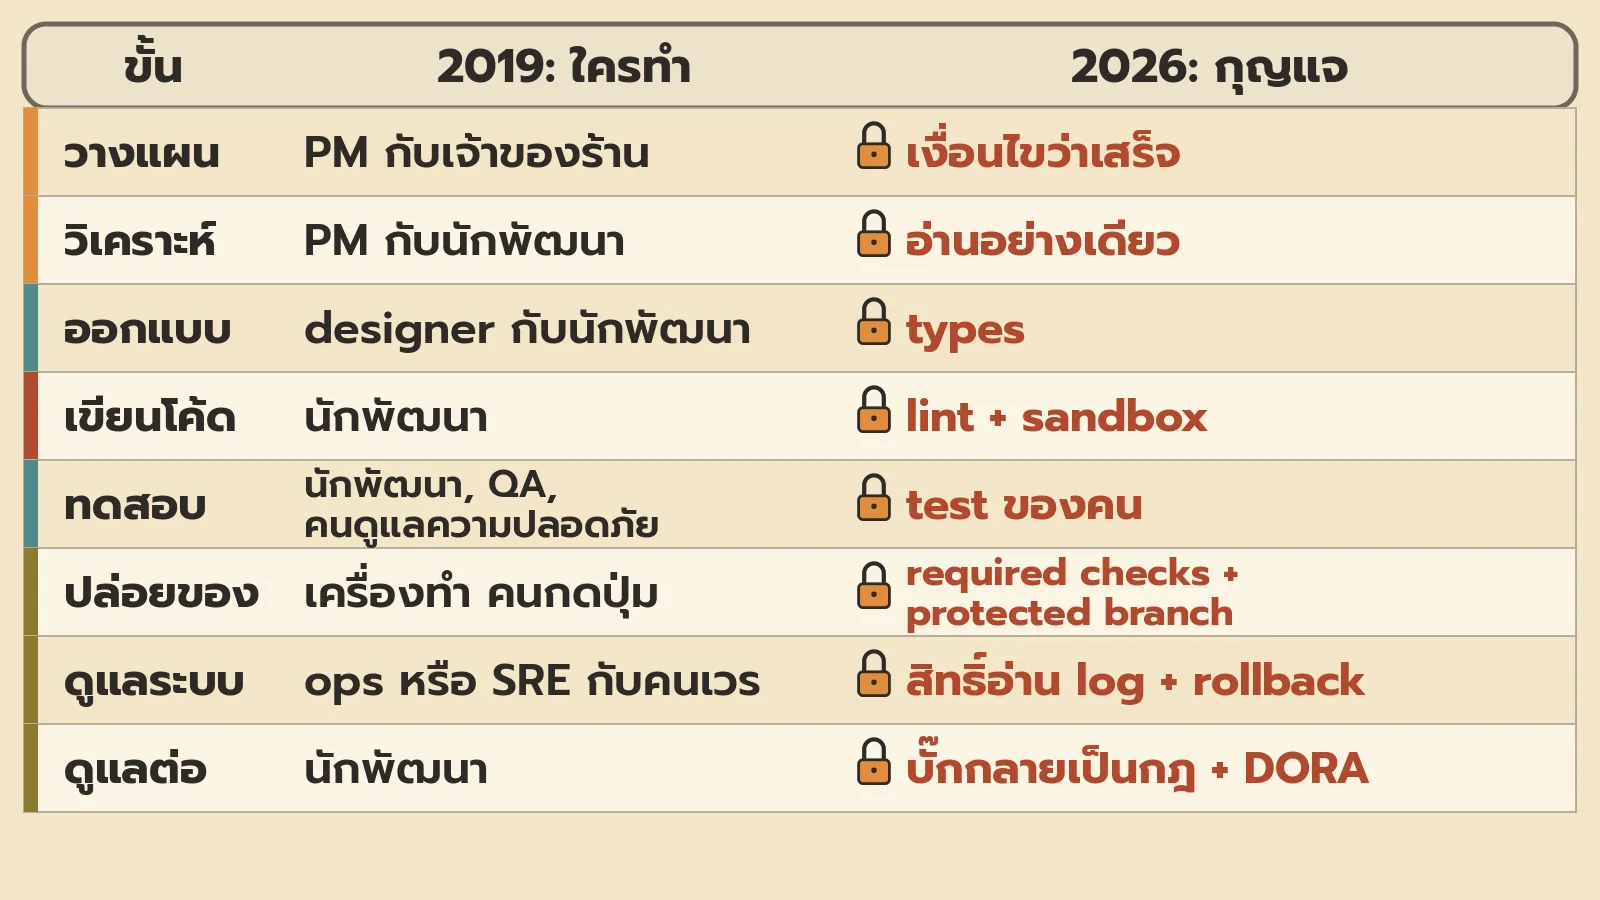
ปี 2019 ทุกช่องมีเครื่องช่วย ยกเว้นก้นตัว V
ปี 2026 ทุกช่องมีเครื่องลงมือ แต่ทุกช่องมีกุญแจ และทุกช่องมีคนเซ็น
ผลของการ์ดใบนี้ เสร็จใน 1 วันแทน 3 วัน แบ่งเป็น pull request เล็กๆ 4 อัน พังจริง 1 ครั้ง แก้ได้โดยไม่ต้องถอยระบบ (ตัวอย่างทีมฝน)
ย้อนดูทั้งภาค 1
ตอนที่ 1 ทำไมต้องย้อนดูของเก่า ก่อนจะเข้าใจ ADLC
ตอนที่ 2 ปี 1956 ยิ่งรู้ว่าผิดช้า ยิ่งเจ็บ
ตอนที่ 3 ยุค 1960 รอยต่อระหว่างคนคือที่ที่ความผิดซ่อนอยู่
ตอนที่ 4 ปี 1986 ให้คนใช้ดูเร็ว
ตอนที่ 5 ปี 1999 โค้ดเสร็จทุกสองสัปดาห์
ตอนที่ 6 ปี 2008 โค้ดถึงมือลูกค้าในวันเดียวกัน
ตอนที่ 7 ปี 2011 พังแล้วรู้เร็ว และฟื้นเร็ว
ตอนที่ 8 ปี 2019 ประกอบทุกอย่างเป็นวงเดียว
ตอนที่ 9 ปี 2022-23 ช่องเขียนโค้ดมีผู้ช่วย แต่คนยังขับทุกขั้น
ตอนที่ 10 ปี 2024-25 agent ลงมือเอง คนกลายเป็นคนเขียนเป้าหมายและคนตรวจ
ตอนที่ 11 ปี 2026 agent ลงมือทุกช่อง แต่ทุกช่องมีกุญแจ
ของหลายอย่างในภาคนี้ยังอยู่ แค่โตขึ้น
| เล่าในตอน | ของยุคนั้น | ปี 2026 |
|---|---|---|
| 2 | FORTRAN | ยังมีมาตรฐานใหม่ Fortran 2023 |
| 3 | COBOL | ยังมีมาตรฐาน ISO ปี 2023 และกำลังปรับรุ่นต่อ |
| 4 | vi | ลูกหลานอย่าง Vim และ Neovim ยังออกรุ่นใหม่ปีนี้ |
| 4, 6 | SCCS / RCS แล้วต่อด้วย git | git ยังออกรุ่นใหม่ปีนี้ |
| 5 | Bugzilla | Mozilla ยังใช้ Bugzilla ของตัวเองอยู่ |
| 5 | JUnit | ออกรุ่น 6 แล้ว |
| 7 | Prometheus | ยังออกรุ่นใหม่ปีนี้ |
| 8 | Docker | ยังออกรุ่นใหม่ปีนี้ |
| 8 | Dependabot | ยังอยู่ใน GitHub และ agent ทำต่อจนจบได้ |
| 10 | AGENTS.md กับ MCP | ย้ายไปอยู่กับมูลนิธิกลางภายใต้ Linux Foundation |
สิ่งที่ผมได้จากยุคนี้
ลองทำเอง
วันสุดท้ายของฝน
ฝนลอกโปสเตอร์วง 8 ขั้นลงจากผนัง ม้วนส่งให้มิว
แนบกระดาษอีกแผ่น เป็นรายการกุญแจ 8 ข้อ ช่องละข้อ
“ป้ายบอก เสากั้น อย่าลืมนะ”
ผมว่าเรื่องสำคัญของตอนนี้คือ คำถามเปลี่ยนจาก “agent ทำอะไรได้” เป็น “ถ้ามันทำผิด อะไรกันไว้ และใครเซ็น”
เก็บศัพท์
| ศัพท์ | ความหมายแบบภาษาคน |
|---|---|
| ADLC | วงการสร้าง software ที่ agent ลงมือทุกขั้น คนตั้งเป้าหมายและอนุมัติตามด่าน |
| guardrail | ราวกั้นที่กันไม่ให้งานหลุดออกนอกทาง |
| ป้าย กับ เสากั้น | ป้ายคือข้อความที่ agent ไม่ทำตามก็ได้ เสากั้นคือโครงสร้างที่ข้ามไม่ได้ |
| type | กติกาว่าข้อมูลแต่ละตัวเป็นอะไรได้บ้าง เขียนผิดแล้วเครื่องไม่ยอม |
| lint | โปรแกรมตรวจโค้ดตามกฎที่ทีมตั้งไว้ |
| required status check | เช็กที่ต้องผ่านก่อนถึงจะรวมงานได้ |
| protected branch | branch ที่ตั้งกติกาไว้ว่าจะรวมงานเข้าได้ต้องผ่านอะไรบ้าง |
| CODEOWNERS | ไฟล์บอกว่าไฟล์ไหนใครเป็นเจ้าของ และต้องให้เจ้าของตรวจ |
| permission | สิทธิ์ว่าใครหรืออะไรอ่านหรือแก้อะไรได้ |
| DORA metrics | ตัวเลขชุดที่ใช้วัดว่าทีมส่งงานเร็วแค่ไหน และระบบนิ่งแค่ไหน |
| change fail rate | ปล่อยของไปกี่ครั้ง พังกี่ครั้ง |
| lead time | เวลาตั้งแต่เขียนโค้ดเสร็จจนถึงมือลูกค้า |
| RCT | การทดลองที่สุ่มแบ่งกลุ่ม แบบที่ METR ใช้ |
จดบันทึก
ถ้าเพิ่งเข้ามาอ่านตอนนี้ ย้อนไปเริ่มที่ตอนที่ 1 ได้ครับ
ภาคนี้ผมไล่ดูมา 11 ตอน ตั้งแต่บัตรเจาะรูจนถึง agent
ทุกยุคแก้ปัญหาเดิมเรื่องเดียว คือทำยังไงให้รู้ว่าผิดเร็วขึ้น และผิดแล้วเจ็บน้อยลง
คืนนั้นมิวเปิดโน้ตบุ๊กเครื่องใหม่ที่บ้าน
ยังไม่มีอะไรเลย ไม่มี repo ไม่มี test ไม่มีทีม
“บริษัทใหญ่มีคนทำทุกช่อง แล้วถ้าเหลือคนเดียว จะตั้งวงนี้เองได้ยังไง”
เรื่องของฝนกับมิวจบแค่นี้ ภาค 2 ผมจะเล่าเรื่องของคนคนหนึ่งที่อยากมีโรงงานแบบนี้คนเดียว แล้วผมจะลองทำตามไปด้วยครับ
คำถามที่พบบ่อย
ADLC คืออะไร?
ADLC ย่อมาจาก Agentic Development Lifecycle คือวงการสร้าง software ที่ agent ลงมือทำแต่ละขั้น ส่วนคนตั้งเป้าหมาย แล้วคอยอนุมัติตามด่านสำคัญ คำนี้ยังไม่ใช่มาตรฐานกลางของวงการ ผมใช้เป็นกรอบเล่าของซีรีส์นี้ครับ
ADLC ต่างจาก SDLC ยังไง?
ขั้นยังเหมือนเดิมทั้ง 8 ขั้น ที่เปลี่ยนคือใครลงมือ SDLC คนลงมือแทบทุกขั้น ส่วน ADLC agent ลงมือ คนตั้งเป้าหมาย วางกุญแจ และตัดสินตามด่าน
เขียนกฎใน AGENTS.md อย่างเดียวพอมั้ย?
ไม่พอครับ AGENTS.md คือป้ายและแผนที่ ช่วยให้ agent ทำถูกบ่อยขึ้น แต่ agent ยังข้ามได้ ต้องมีเสากั้นอย่าง type, lint, test และประตูก่อนรวมงานด้วย
ถ้าจะเริ่มวัดทีม ควรวัดอะไรก่อน?
เริ่มจากตัวเลข DORA ได้ครับ ใช้เวลานานแค่ไหนกว่าโค้ดถึงมือลูกค้า ปล่อยบ่อยแค่ไหน ปล่อยแล้วพังกี่ครั้ง และฟื้นเร็วแค่ไหน แล้วเทียบก่อนกับหลังใช้ AI ของทีมตัวเอง
คนเดียวตั้งวงแบบนี้ได้มั้ย?
นี่คือคำถามที่ภาค 2 จะลองตอบด้วยการลงมือจริงครับ
Next → จบภาค 1 แล้วครับ ภาค 2 ผมจะเล่าเรื่องของคนคนหนึ่งที่อยากมีโรงงานแบบนี้คนเดียว แล้วผมจะลองทำตามไปด้วยครับ